Kaggle比赛:Titanic - Machine Learning from Disaster 链接:
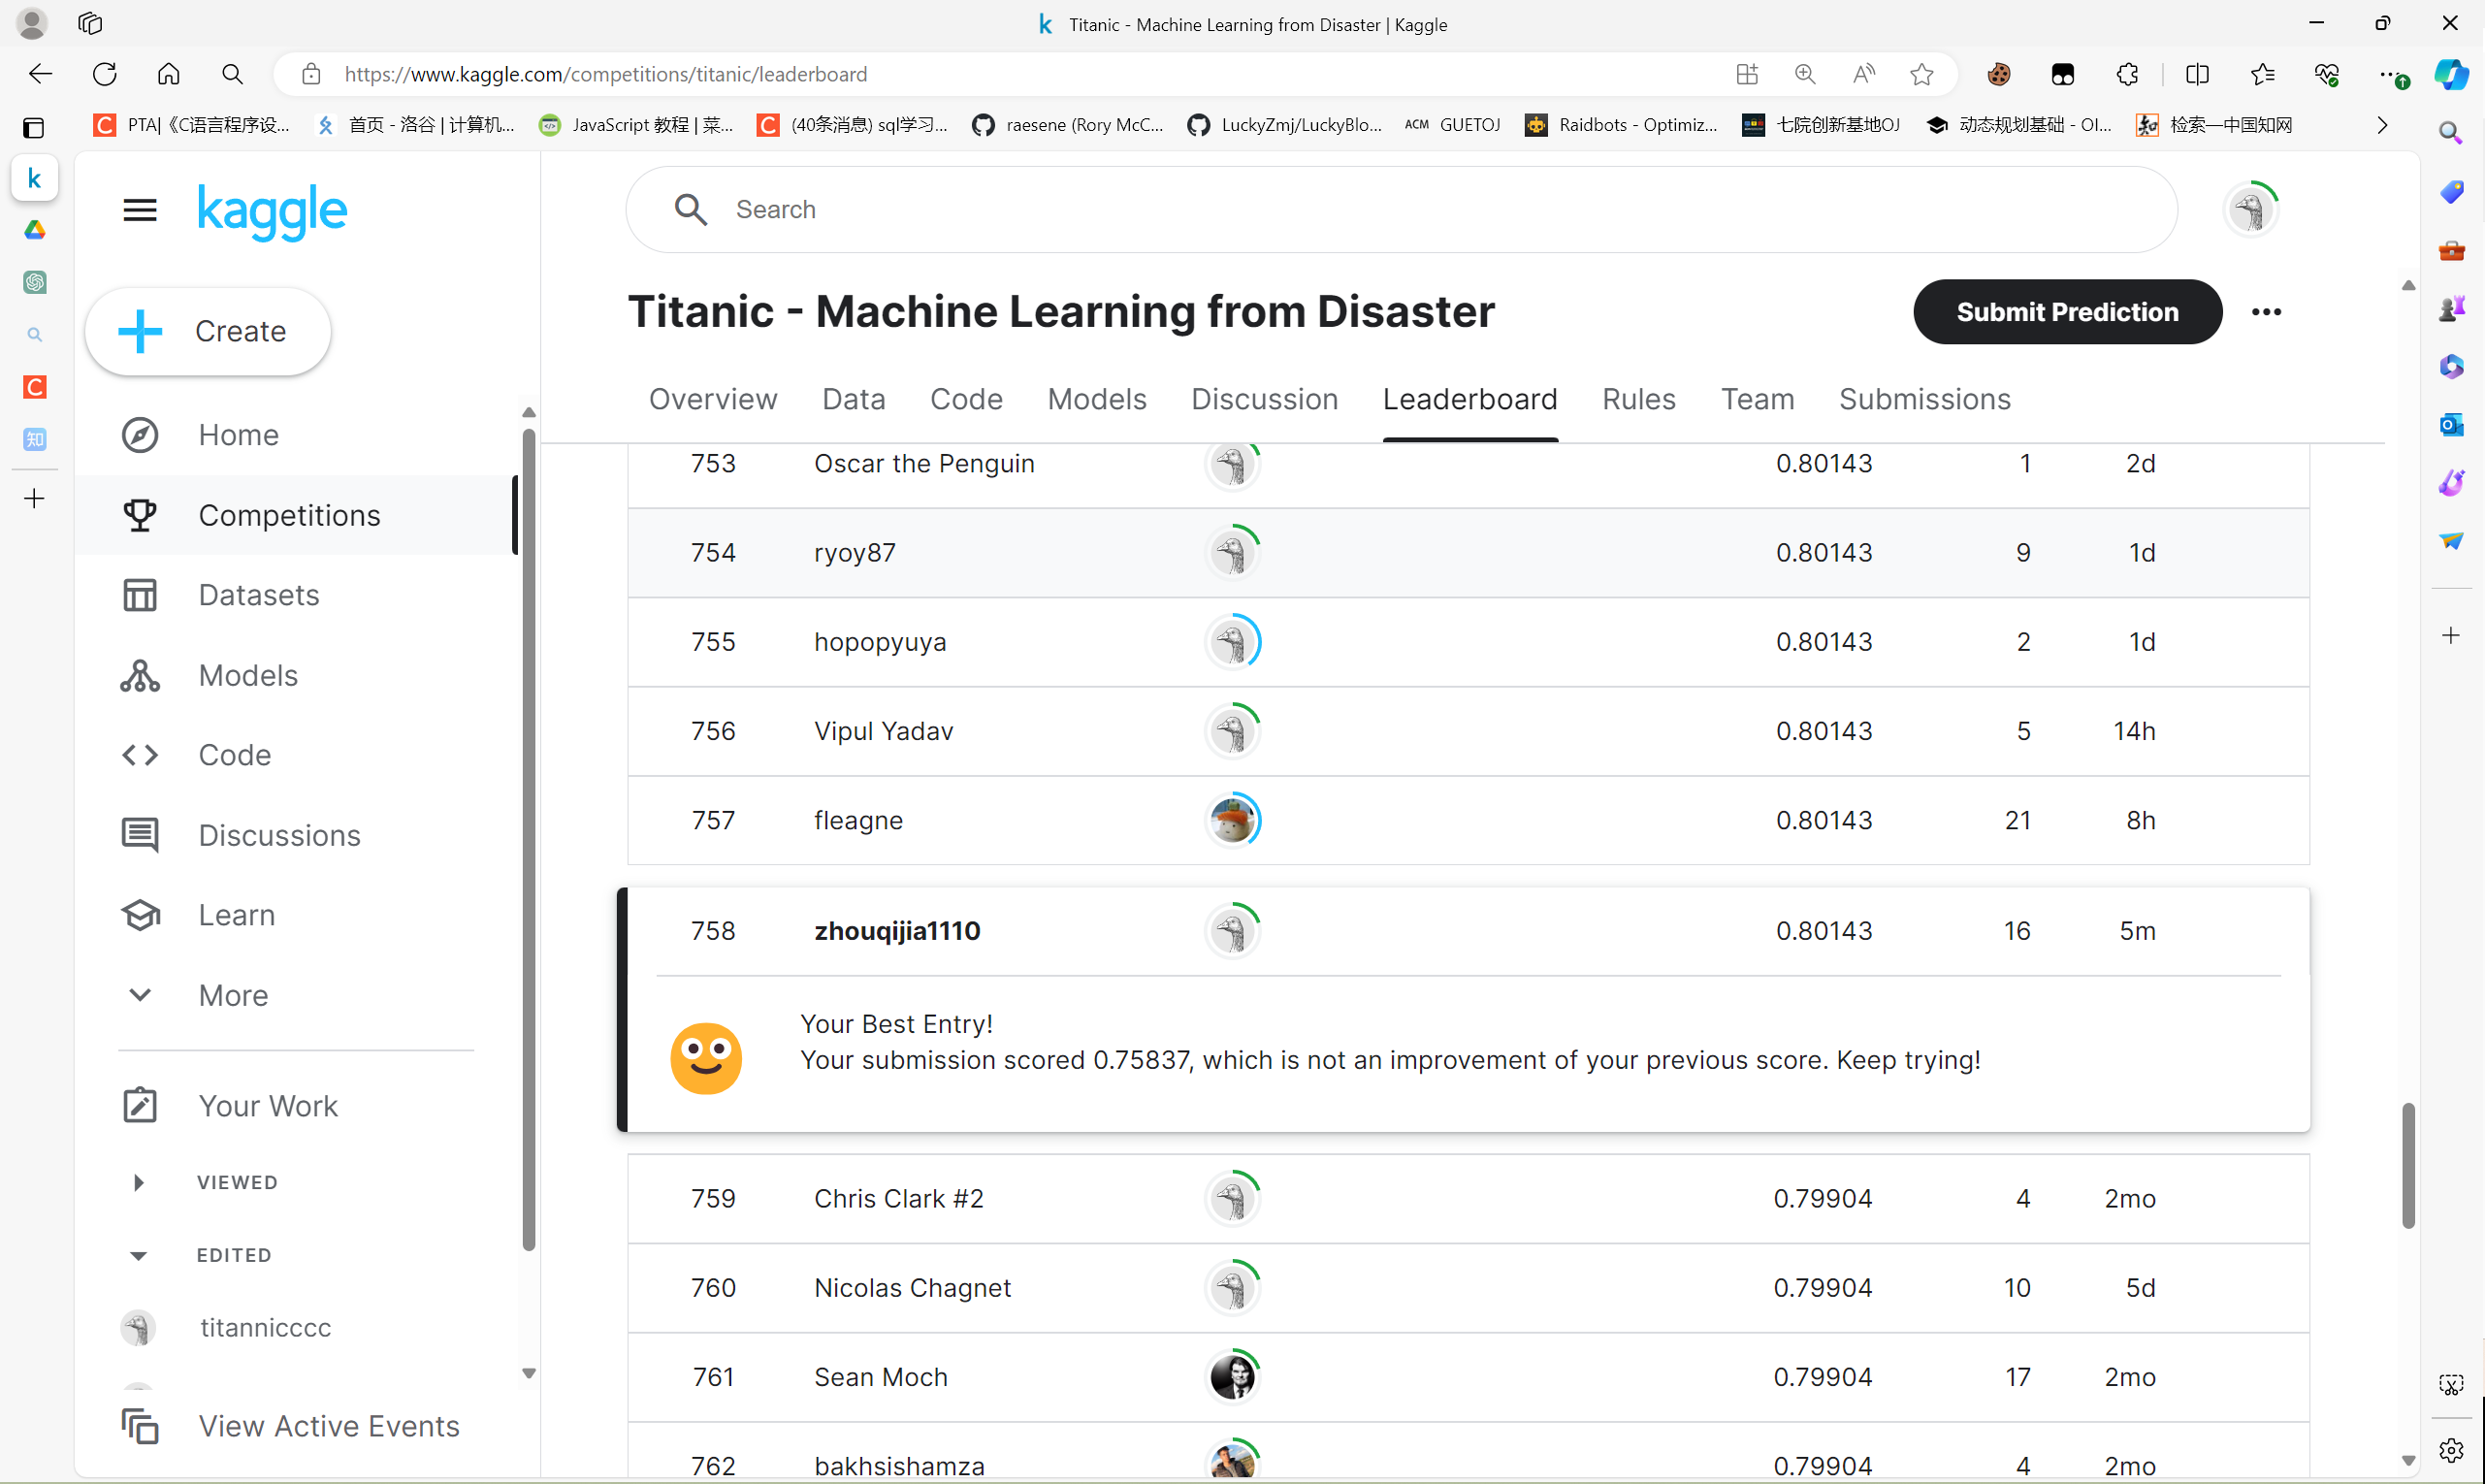
成绩758/15641(2024.4.21):
还算不错吧,虽然是学习赛但好歹也是个**5%**嘻嘻
代码分析及思路 导入包与数据集 所有的包都放在一个代码块了,个人习惯而已
1
2
3
4
5
6
7
8
9
10
11
12
13
14
import numpy as npimport pandas as pdimport seaborn as snsimport matplotlib.pyplot as pltimport scipy.stats as statsfrom sklearn.model_selection import train_test_splitimport xgboost as xgbfrom sklearn.metrics import accuracy_scorefrom sklearn.metrics import confusion_matrix, precision_score, recall_score, f1_scorefrom scipy.stats import pointbiserialrfrom scipy.stats import chi2_contingencyfrom sklearn.tree import DecisionTreeRegressorfrom sklearn.impute import SimpleImputerfrom sklearn.model_selection import GridSearchCV
1
2
3
4
5
data_train = pd.read_csv(& data_test = pd.read_csv(& data_train.info() data_test.info()
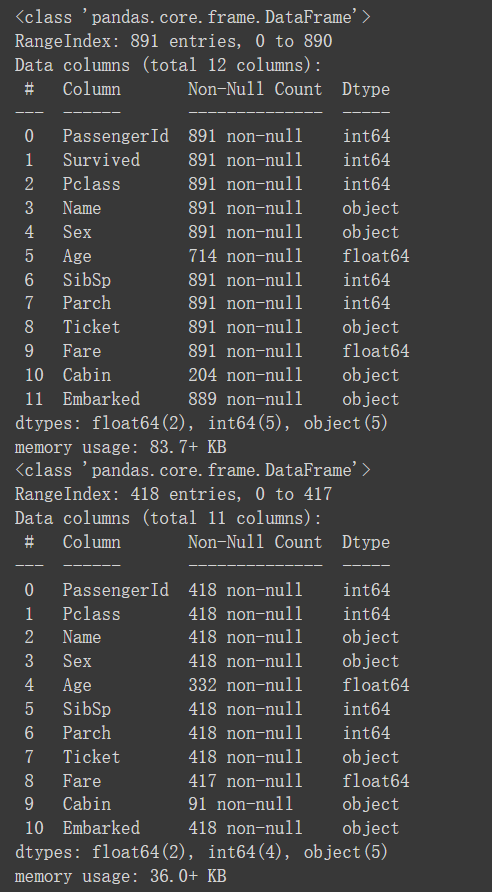
导入数据,并通过info查看基本信息,describe也可以,还是个人习惯,主要是int和float不太适用于后续的树模型(xgboost)
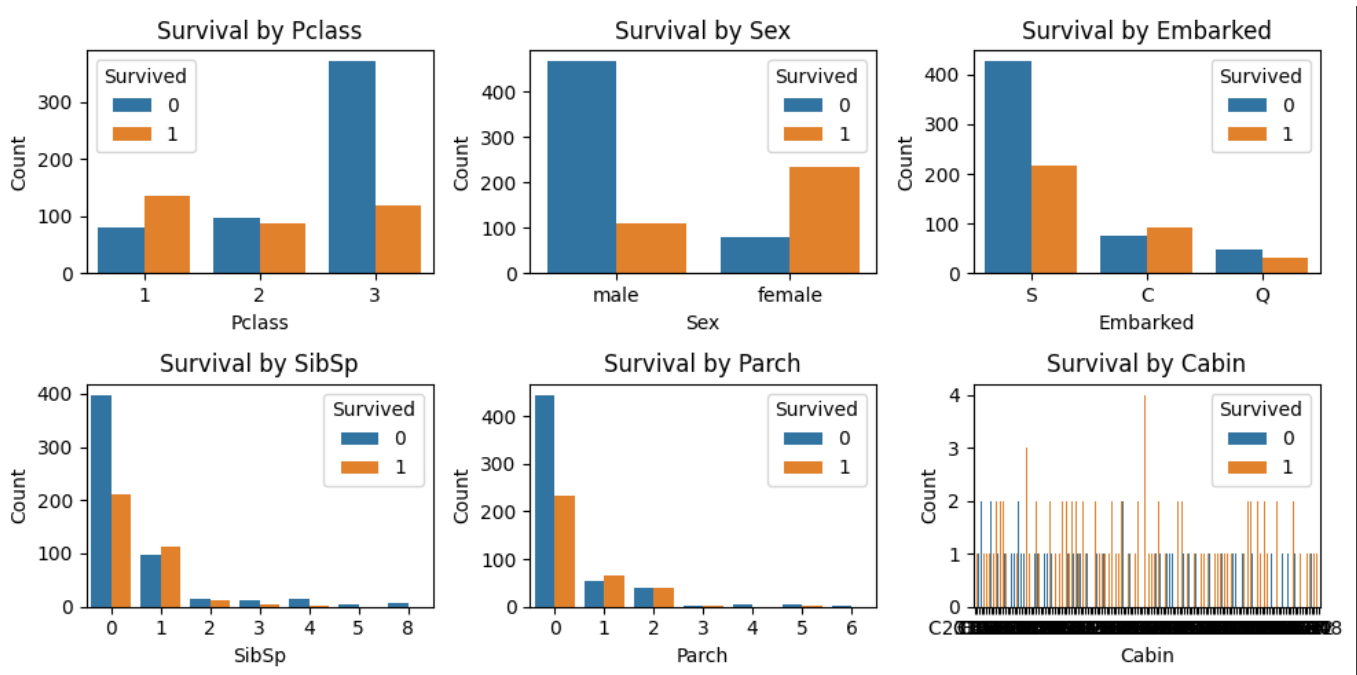
数据探索 这一块主要是为了做描述性统计的,做一些基础的分析
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 fig, axes = plt.subplots(1 , 2 , figsize=(4 , 5 )) data = data_train sns.boxplot(data[& axes[0 ].set_title(& axes[0 ].set_ylabel(& sns.boxplot(data[& axes[1 ].set_title(& axes[1 ].set_ylabel(& plt.tight_layout() plt.figure(figsize=(12 , 6 )) plt.subplot(1 , 2 , 1 ) sns.kdeplot(data=data[data[& sns.kdeplot(data=data[data[& plt.xlabel(& plt.ylabel(& plt.title(& plt.legend() plt.subplot(1 , 2 , 2 ) sns.kdeplot(data=data[data[& sns.kdeplot(data=data[data[& plt.xlabel(& plt.ylabel(& plt.title(& plt.legend() plt.tight_layout() plt.figure(figsize=(10 , 5 )) plt.subplot(2 , 3 , 1 ) sns.countplot(x=& plt.xlabel(& plt.ylabel(& plt.title(& plt.subplot(2 , 3 , 2 ) sns.countplot(x=& plt.xlabel(& plt.ylabel(& plt.title(& plt.subplot(2 , 3 , 3 ) sns.countplot(x=& plt.xlabel(& plt.ylabel(& plt.title(& plt.subplot(2 , 3 , 4 ) sns.countplot(x=& plt.xlabel(& plt.ylabel(& plt.title(& plt.subplot(2 , 3 , 5 ) sns.countplot(x=& plt.xlabel(& plt.ylabel(& plt.title(& plt.subplot(2 , 3 , 6 ) sns.countplot(x=& plt.xlabel(& plt.ylabel(& plt.title(& plt.tight_layout() plt.show()
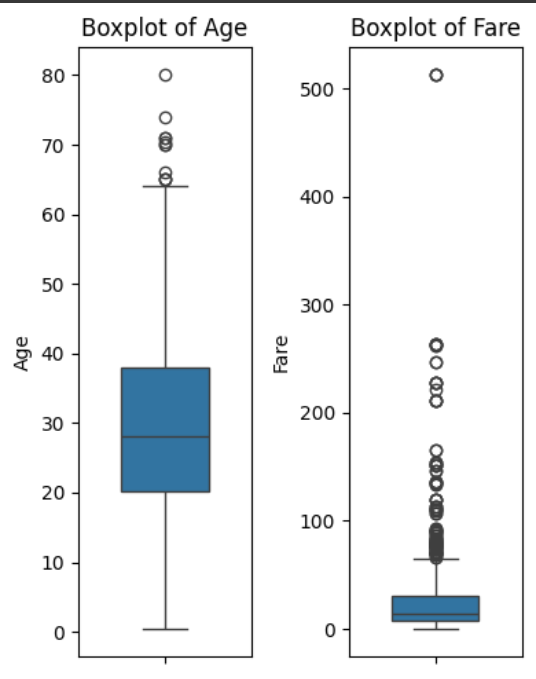
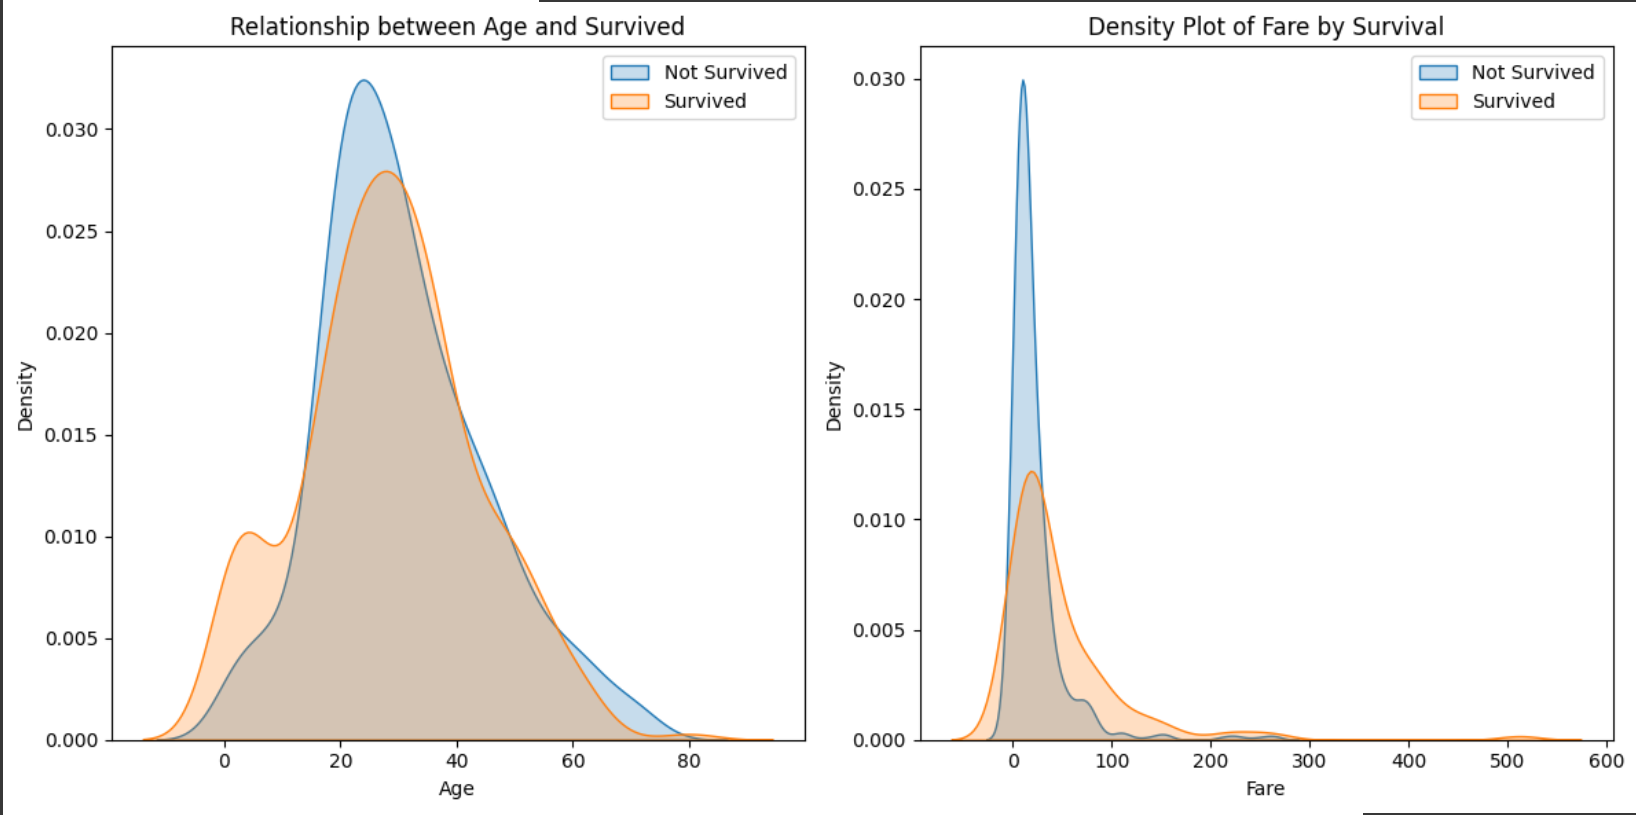
Survived为二分类变量。需要注意的是,数值型变量分布可以有箱线图表出;对于分类变量可以有KDE表出,如下:
结论可以由上看出,不多说了
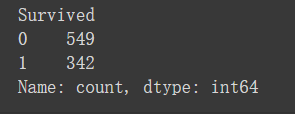
最后再查看样本分布数量
1 2 3 survived_counts = data[& print (survived_counts)
其实是不怎么平衡的,最好在这里使用SMOKE或上采样等方法,这应该是一个上分点
数据挖掘 数据预处理 1. 缺失值处理
train中缺少Age,Cabin与Embraked,test缺少Age,Cabin与Fare。Age,Cabin是大头,其他两个只缺了5个以下所以直接用众数填补(也可以删,但是test需要提交所以不能删)
在此使用模型预测Age(单一决策树)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 def fill_missing_values (df ): fare_imputer = SimpleImputer(strategy=& df[& embarked_imputer = SimpleImputer(strategy=& df[& known_age = df[df[& unknown_age = df[df[& X_train = known_age.drop([& y_train = known_age[& X_test = unknown_age.drop([& dt_regressor = DecisionTreeRegressor(random_state=42 ) dt_regressor.fit(X_train, y_train) predicted_age = dt_regressor.predict(X_test) filled_df = df.copy() filled_df.loc[filled_df[& return filled_df
如果使用xgboost的话,是不怎么需要处理异常值与缺失值的,但是后文还有其他工程,因此先处理。这种办法的问题就在于需要让自己模型预测值的准确率高,不然就是瞎填补
对于Cabin来说,由于缺失值太多,这里处理为:有值的为1,没值的为0
注意一个点,修改的时候必须训练集与测试集一起修改 。不然模型是预测不了特征个数不对的对应文件的。后文不再赘述
2. 异常值处理
懒的搞了,相信xgboost
3. SibSp与Parch
在此选择相加,但是普通的相加减在树模型中是无效的(加不加对模型的精度都没有提升)。
1 2 3 4 5 data[& data = data.drop([& test_data[& test_data = test_data.drop([&
4. Embarked
在此将其转为1,2,3变量
5. Ticket
我不会处理,对于文本类的真的不是很熟悉,在此我直接删掉这个特征了(别学我)
1 2 3 data = data_train.drop([& test_data = data_test.drop([&
特征工程 1. 对Name处理
在此借用讨论区大神的办法,我直接删掉,但是大神说通过前缀可以看出这个人的社会地位,因此做整合
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 data[& data[& data[& data[& data[& data[& data[& data = pd.get_dummies(data, columns=[& data = data.drop([& test_data[& test_data[& test_data[& test_data[& test_data[& test_data[& test_data[& test_data = pd.get_dummies(test_data, columns=[& test_data = test_data.drop([&
2. 分箱操作
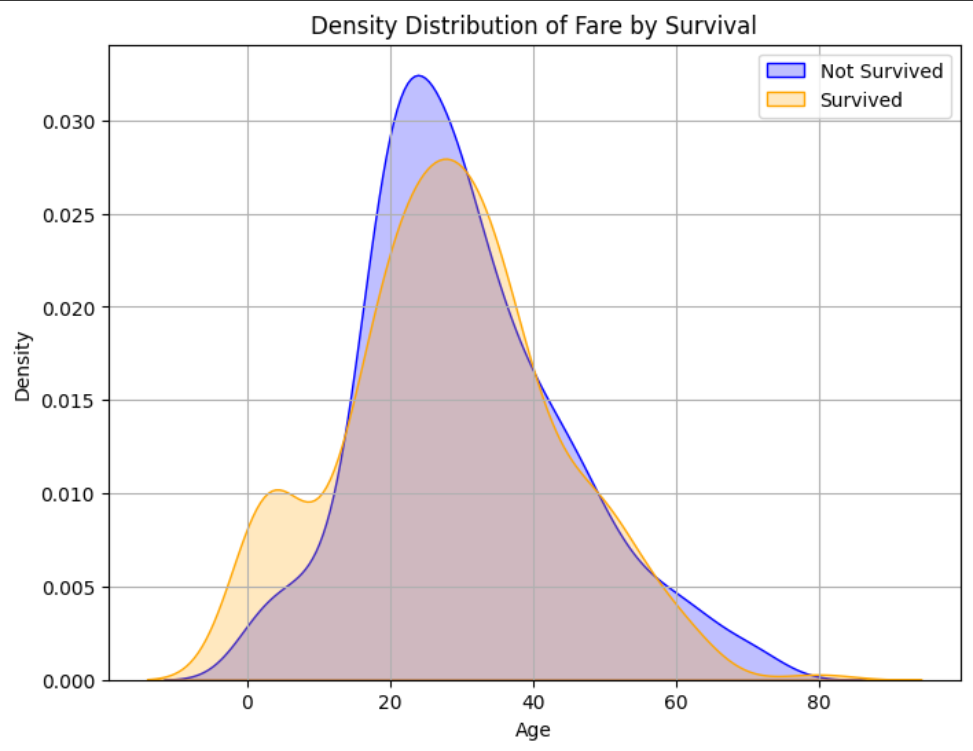
将Age和Numbers进行分箱,模型可以捕捉其中的非线性关系(需要先画qq图观察);Age的异常值过多,分区间后可以使数据更加稠密,降低异常值的影响
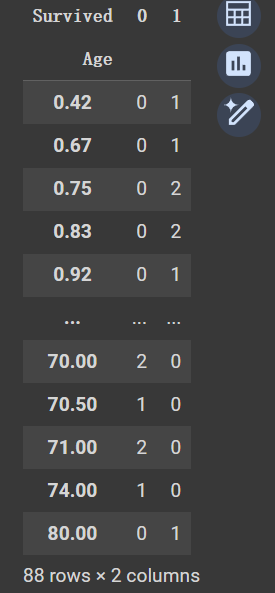
首先观察原始分布,为自定义边界做准备
1 2 3 4 5 6 7 8 9 10 11 12 13 14 plt.figure(figsize=(8 , 6 )) sns.kdeplot(data=data[data[& sns.kdeplot(data=data[data[& plt.title(& plt.xlabel(& plt.ylabel(& plt.legend() plt.grid(True ) plt.show() cross_tab = pd.crosstab(data[& cross_tab
如下图所示结果,Numbers也是一样的,不做演示了
这样就可以明确分组边界了
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 bins = [0 , 5 , 18 , 30 , 40 , 50 , 80 ] labels = [& data[& data = pd.get_dummies(data, columns=[& data = data.drop([& test_data[& test_data = pd.get_dummies(test_data, columns=[& test_data = test_data.drop([& bins = [0 , 1 , 2 , 3 , 10 ] labels = [& data[& data = pd.get_dummies(data, columns=[& data = data.drop([& test_data[& test_data = pd.get_dummies(test_data, columns=[& test_data = test_data.drop([&
分组边界都是自己画描述性统计自己分的。其实还有一个Fare作为连续性变量也需要分,但是我分出来之后发现精度反而变滴了,期待有人可以帮我解决疑惑
3. 哑变量处理
将Sex,Embarked分类特征转化为哑变量,有一个疑问是:Embarked按理说应该做哑变量处理,但是我转为1,2,3这样int型反而精更好。不明白为啥
1 2 3 4 5 data = pd.get_dummies(data, columns=[& data[& test_data = pd.get_dummies(test_data, columns=[& test_data[&
模型 本文使用XGBoost,这个世界上最tmd好用的树模型!!!
1. 预测与保存
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 X = data.drop([& y = data[& X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2 , random_state=42 ) print (X_train.dtypes)model = xgb.XGBClassifier() model.fit(X_train, y_train) y_pred = model.predict(X_test) test_predictions = model.predict(test_data) results = pd.DataFrame({& results.to_csv(&
其实还有模型调参的部分,但是我调参之后精度反而下降了不少,不懂这是啥原因,可能是做的过于简单了
2. 模型评估
F1,精确率,准确率,召回率和混淆矩阵进行评估
1 2 3 4 5 6 7 8 9 10 11 12 accuracy = accuracy_score(y_test, y_pred) print ("准确率:", accuracy)conf_matrix = confusion_matrix(y_test, y_pred) print ("混淆矩阵:")print (conf_matrix)precision = precision_score(y_test, y_pred) print ("精确率:", precision)recall = recall_score(y_test, y_pred) print ("召回率:", recall)f1 = f1_score(y_test, y_pred) print ("F1指标:", f1)
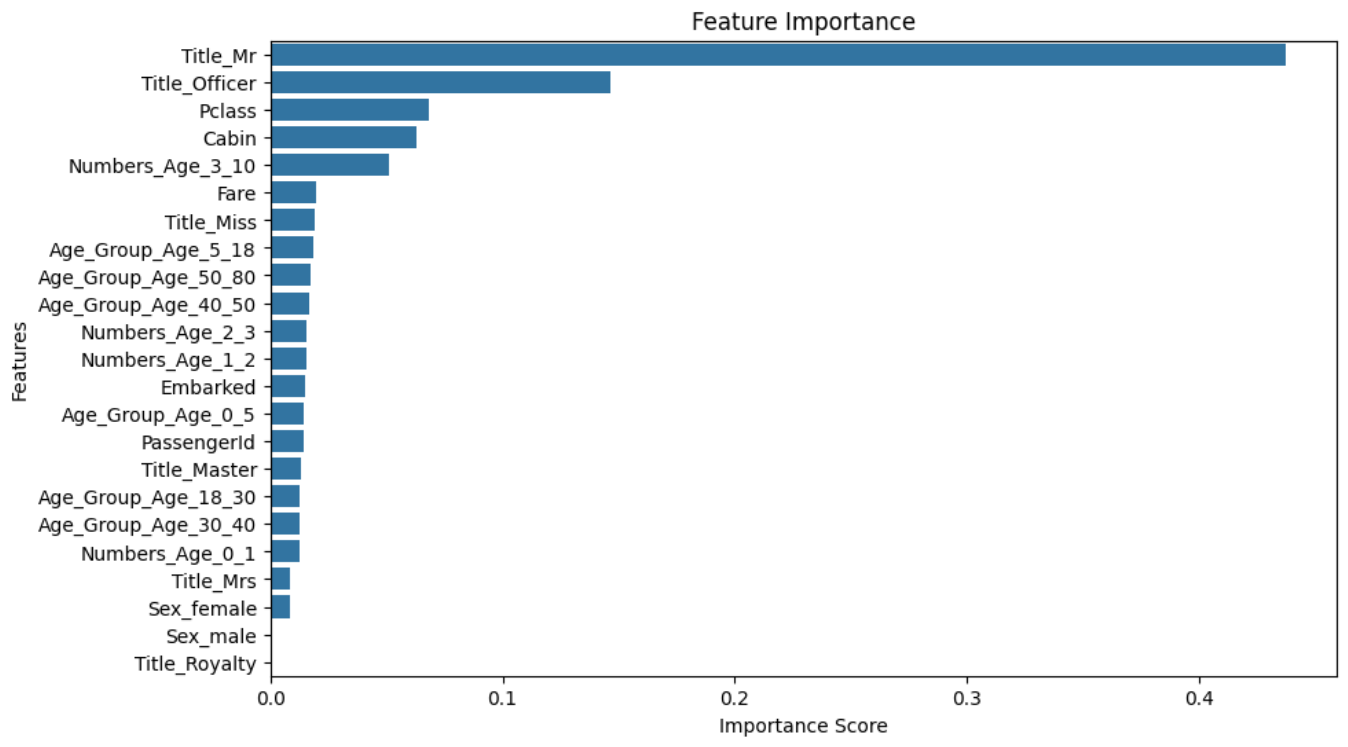
还有一个点,针对树模型可以画出基尼指数做判断,代码与运行结果如下:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 feature_importance = model.feature_importances_ feature_importance_df = pd.DataFrame({& feature_importance_df = feature_importance_df.sort_values(by=& plt.figure(figsize=(10 , 6 )) sns.barplot(x=& plt.title(& plt.xlabel(& plt.ylabel(& plt.show()
交叉验证 我只能说,你永远可以相信你在本地交叉验证的结果!!!
我自己的精确度为0.83240,提交后的为0.80143,有点过拟合吧?但是交叉验证出来的值非常对,达到了惊人的0.80035。
1 2 3 4 5 6 7 8 9 10 11 12 13 from sklearn.model_selection import cross_val_scoreX = data.drop([& y = data[& model = xgb.XGBClassifier() scores = cross_val_score(model, X, y, cv=5 ) print ("交叉验证得分:", scores)print ("平均交叉验证得分:", scores.mean())
总结
XGBoost真的很好用
分箱操作很重要
千万不要删特征,要做特征工程的转换
最后一定要用到交叉分析
改进与疑惑 上分点
模型的调参
Fare的分组
对Ticket的处理
异常值分类处理
疑惑
按理说Embarked应该转为哑变量啊,但是数值型变量反而提升了进度
模型调参不对,下次再试试看
Fare的分箱处理,我没处理好不知道是为啥
PassengerID按理说没啥用,但是去掉之后又下降了,不理解