深度Q网格(Deep Q-network, DQN)
在第二章Markov的时候,我们已经了解到了$V(s)$和$Q(s,a)$,但如果说连续型空间的话,存在无数个情况,表格型直接爆炸,所以我们需要价值函数近似利用函数直接拟合状态价值函数或动作价值函数,降低了对存储空间的要求
给出价值函数近似公式,
$Q_\phi(s, a)$是一个参数为$\phi$的函数,比如神经网络,其输出为一个实数,称为 Q 网络(Q-network)。
概括一下就是,本来是用表格计算每一个,现在用神经网络拟合计算
1.1 状态价值函数
DQN是基于价值的算法,在其中我们学习的不是策略,而是评论员(critic)。评论员有很多,比如状态价值函数($V(s)$),等等
这里需要强调,评论员无法凭空评价一个状态的好坏,它所评价的是在给定某一个状态的时候,如果接下来交互的演员的策略是$\pi$,我们会得到多少奖励,这个奖励就是我们评价得出的值。
$V(s)$计算有两种,第三章的时候都讲过了,基于蒙特卡洛的方法和基于时序差分的方法
1.2 动作价值函数
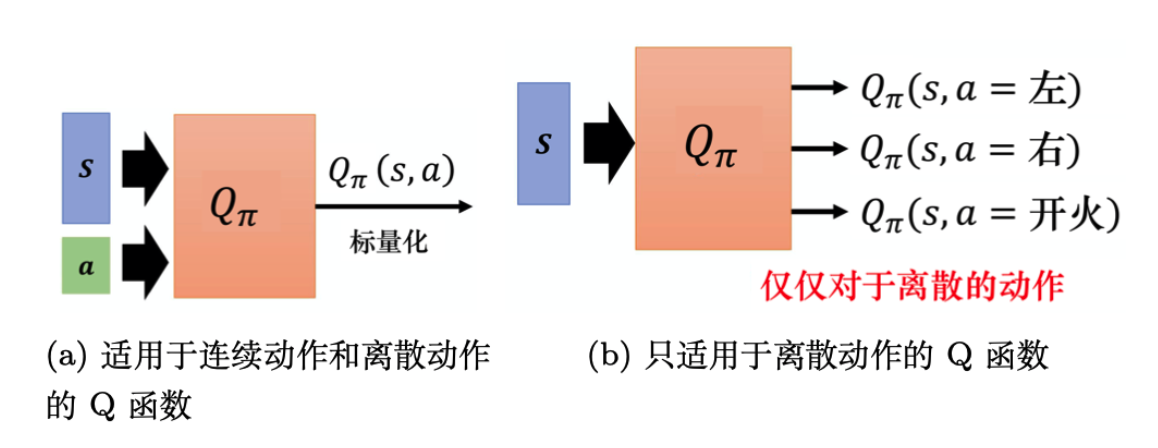
也就是Q函数,不过需要注意Q函数有两种写法
1.3 目标网络(target network)
这部分就是用来代替Q-table的。先介绍该网络的架构,再介绍如何使用到DQN中
1.3.1 网络架构
input layer:n个node,其中node代表为states
Hidden layer: 任选
Output layer: n个node,其中node代表为action
1.3.2 DQN中的目标网络
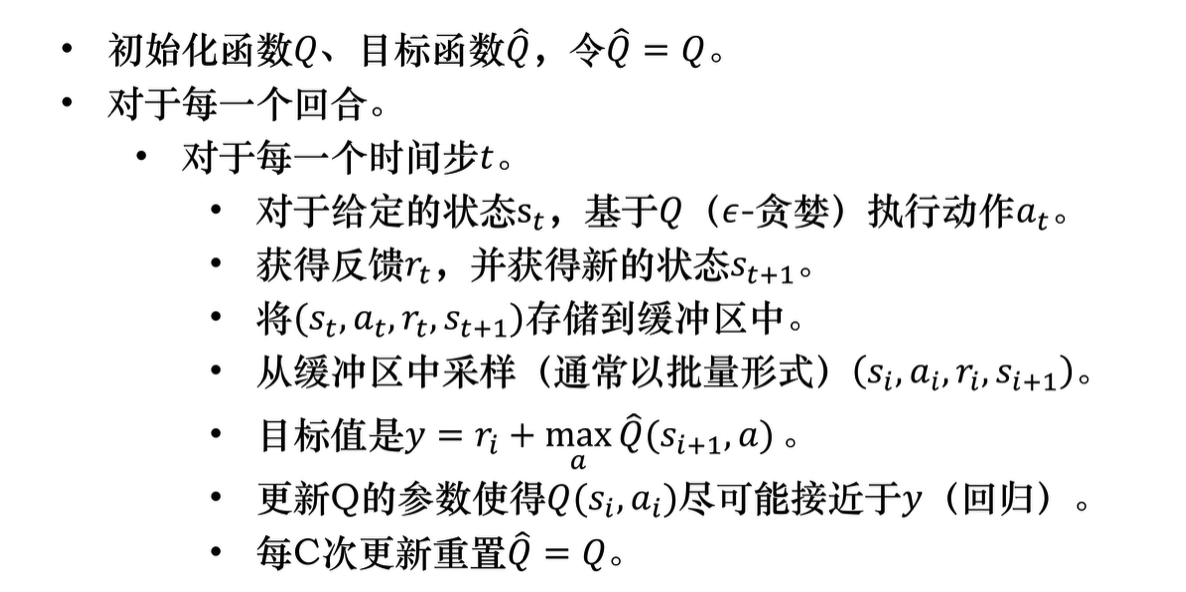
DQN训练的时候会有两个目标网络,假设左边一个右边一个,训练的时候我们只更新左边Q网络的参数(通过梯度下降),然后copy一份给右边(可能n轮迭代之后),我们先以一轮迭代就copy的情况来看
step1:左边训练好了网络,并copy一份给右边
Step2:根据该公式,计算正确的值
1 | q(s, a) = reward if new_state is terminal else |
step3: 将更新后的输出传递给左边,进行回归训练
1.4 探索(exploration)
第二章也讲过了,反正用e贪心即可
1.5 经验回放(experience replay)
**简单来说,它的核心思想就是:**不要做完一个动作就马上只拿这个动作去训练,而是先把经历存起来,等到一定时候,随机抽出一把旧的经历来训练。
1.6 算法流程