近端策略优化(proximal policy optimization,PPO)
PPO是策略梯度的变形,首先给出强化学习的默认梯度更新公式
问题在于,一旦更新了参数$\theta \rightarrow \theta'$,$p_\theta(\tau)$的值也会修改,这就意味着之前采样的数据也不能用了,又得重新采集一次数据,消耗大量的时间
这样就可以用另外一个策略$\pi_{\theta'}$、另外一个演员$\theta'$与环境交互($\theta'$被固定了),用$\theta'$采样到的数据去训练$\theta$。假设我们可以用$\theta'$采样到的数据去训练$\theta$,我们可以多次使用$\theta$采样到的数据,可以多次执行梯度上升(gradient ascent),可以多次更新参数, 都只需要用同一批数据。因为假设$\theta$有能力学习另外一个演员$\theta'$所采样的数据,所以$\theta'$只需采样一次,并采样多一点的数据,让$\theta$去更新很多次,这样就会比较有效率。
1. 重要性采样(importance sampling)
1.1 定义
对于一个随机变量,我们通常用概率密度函数来刻画该变量的概率分布特性。具体来说,给定随机变量的一个取值,可以根据概率密度函数来计算该值对应的概率(密度)。反过来,也可以根据概率密度函数提供的概率分布信息来生成随机变量的一个取值,这就是采样。因此,从某种意义上来说,采样是概率密度函数的逆向应用。与根据概率密度函数计算样本点对应的概率值不同,采样过程往往没有那么直接,通常需要根据待采样分布的具体特点来选择合适的采样策略。
对于一般的概率密度求期望,如下
这是通过蒙特卡罗求积分的方法,因为电脑算不懂积分,如下给出标准公式
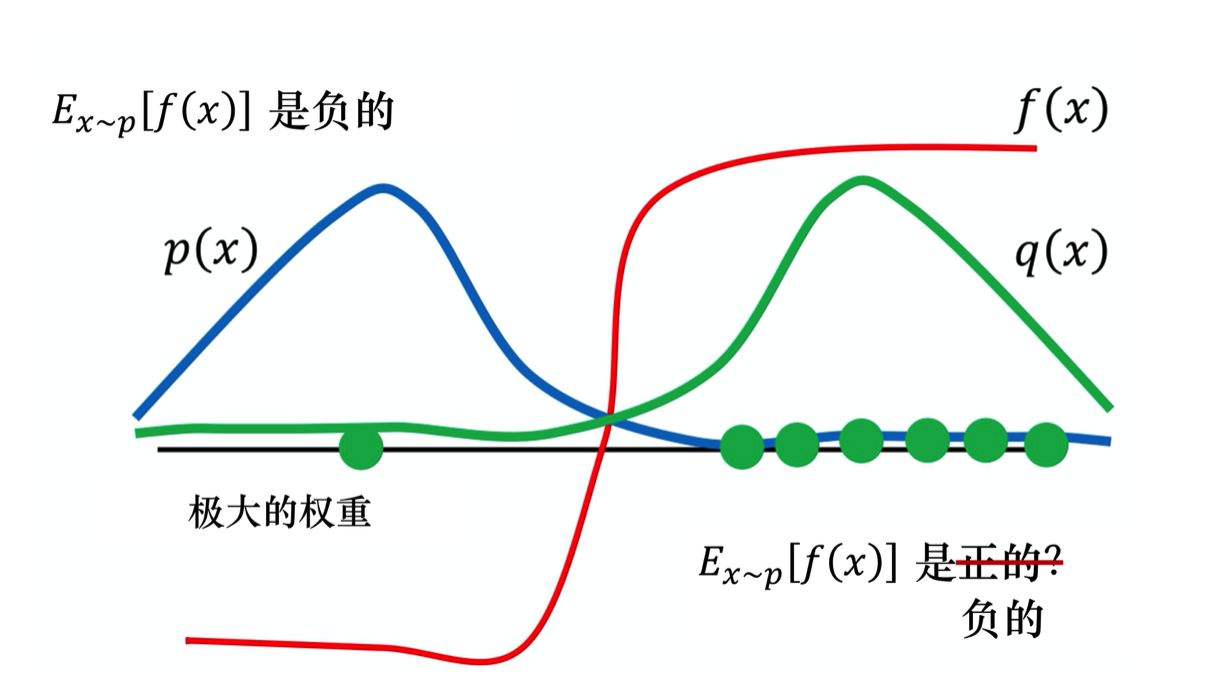
where $f(x)$ is the function itself and $p(x)$ means probability density.我们可以做一个简单的变换,就得到了重要性采样的公式
Where $\frac{p(x)}{q(x)}$ means weight, so we get the final equation, given by
图如下所示
1.2 强化学习异策略中的重要性采样
It’s similar but only add one part ,which is
In fact, when we use importance sampling, we should opt the objective function
2. 近端策略优化(proximal policy optimization,PPO)
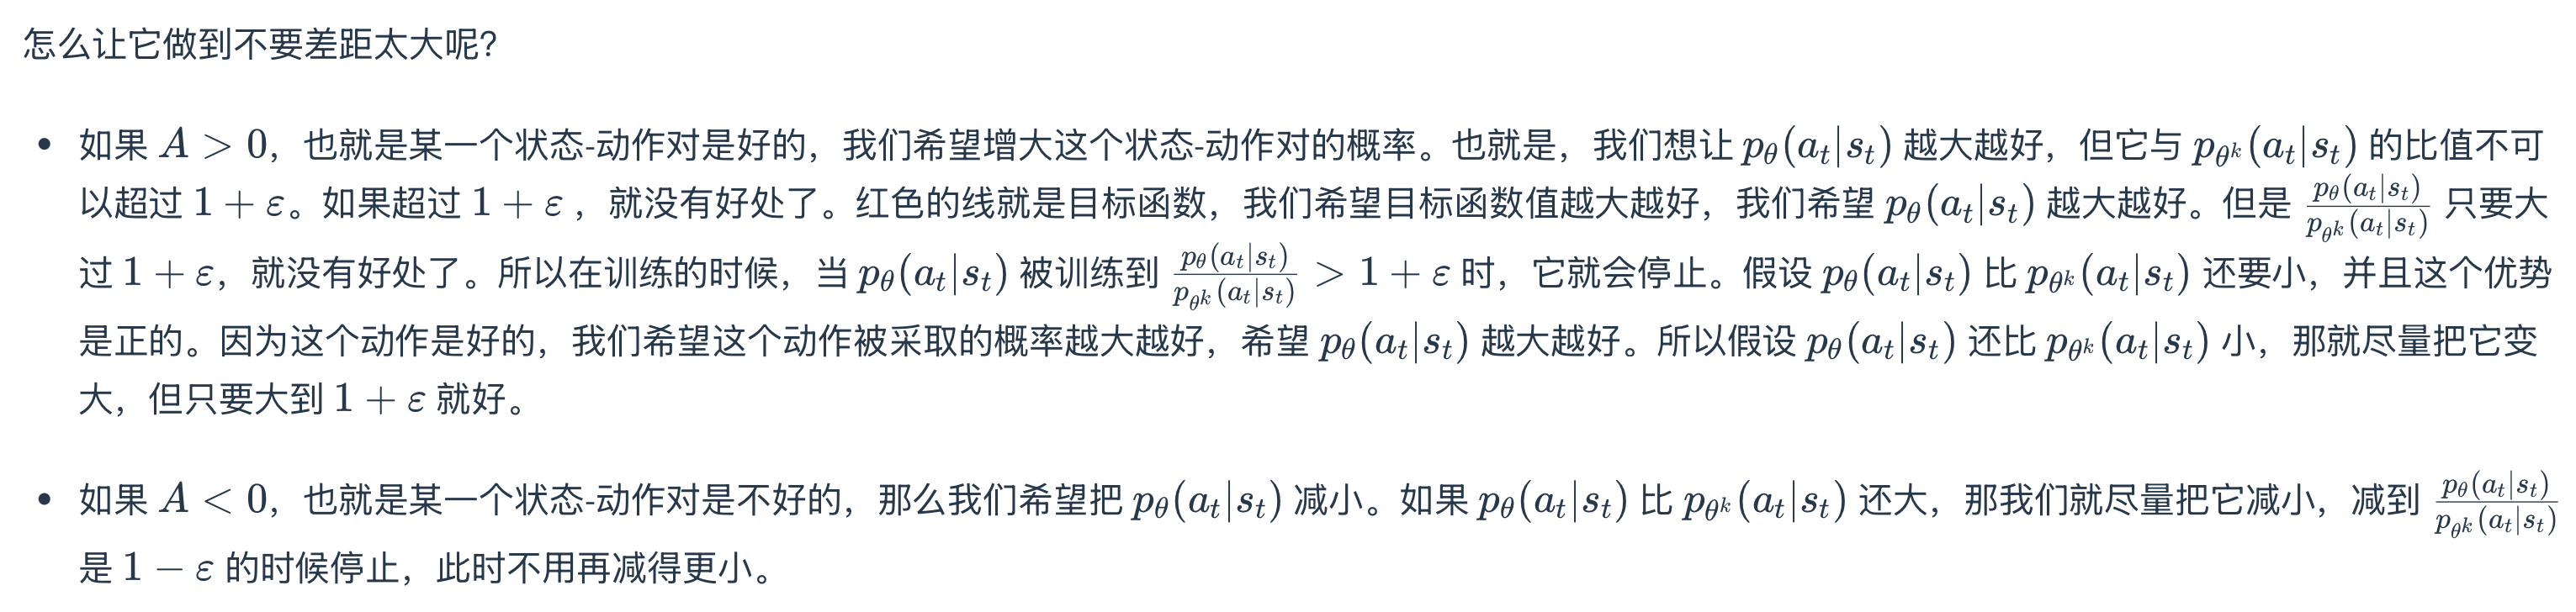
我们可以通过重要性采样把同策略换成异策略,但重要性采样有一个问题:如果$p_\theta(a_t \mid s_t)$与$p_{\theta'}(a_t \mid s_t)$相差太多,即这两个分布相差太多,重要性采样的结果就会不好。 怎么避免它们相差太多呢?这就是PPO要做的事情。首先给出公式
PPO还有一个前身,叫信任区域策略优化(trust region policy optimization,TRPO),如下
两者的不同点在于KL的位置,PPO放在了优化函数中,这样就可以使用梯度上升的方法最大化,但TRPO将其作为强约束,基于梯度的优化难以处理约束条件。总体而言,PPO计算更方便
KL,又称为KL散度,计算的是$\theta$和$\theta'$的距离,也就是相似度,需要注意的是不能计算两参数距离的理由是:参数的变化与动作的变化不一定是完全一致的
PPO 算法有两个主要的变种
2.1 近端策略优化惩罚(PPO-penalty)
先说公式,和ppo其实是差不多的,主要就是k,意思是第k轮迭代,即
如何设置$\beta$呢?此处就需要引入自适应KL散度(adaptive KL divergence)。动态调整$\beta$的值,使其可以随地大小变。先设一个可以接受的 KL 散度的最大值。假设优化以后,KL 散度的值太大,这就代表后面惩罚的项$\beta KL(\theta, \theta^k)$没有发挥作用,我们就把$\beta$增大。另外,我们设一个 KL 散度的最小值。如果优化完以后,KL 散度比最小值还要小,就代表后面这一项的效果太强了,我们怕他只优化后一项,使$\theta$与$\theta^k$一样,这不是我们想要的,所以我们要减小$\beta$。$\beta$是可以动态调整的,因此我们称之为自适应KL惩罚(adaptive KL penalty)。即
if $KL(\theta, \theta^k)$ > $KL_{max}$ then increase $\beta$
if $KL(\theta, \theta^k)$ < $KL_{min}$ then decrease $\beta$
简化表达式为
其中,$A^{\theta^k}(s_t, a_t)$代表的是优势函数(Advantage Function),用于给当前的动作进行打分,定义为
**语文解读就是,这个动作比起平均水平,到底好多少?**本质就是一个归一化操作
2.2 近端策略优化裁剪(PPO2,PPO-cilp)
就是没有KL散度(因为算起来太麻烦了),所需最大化的目标函数为
其中,裁剪函数clip的作用是,在括号里面有3项,如果第一项小于第二项,那就输出$1-\epsilon$;第一项如果大于第三项,那就输出$1+\epsilon$。$\epsilon$是一个超参数
clip的含义就是,输出需在给定的范围[a,b]内,大于就取最大的$b$,小于就取最小的$a$
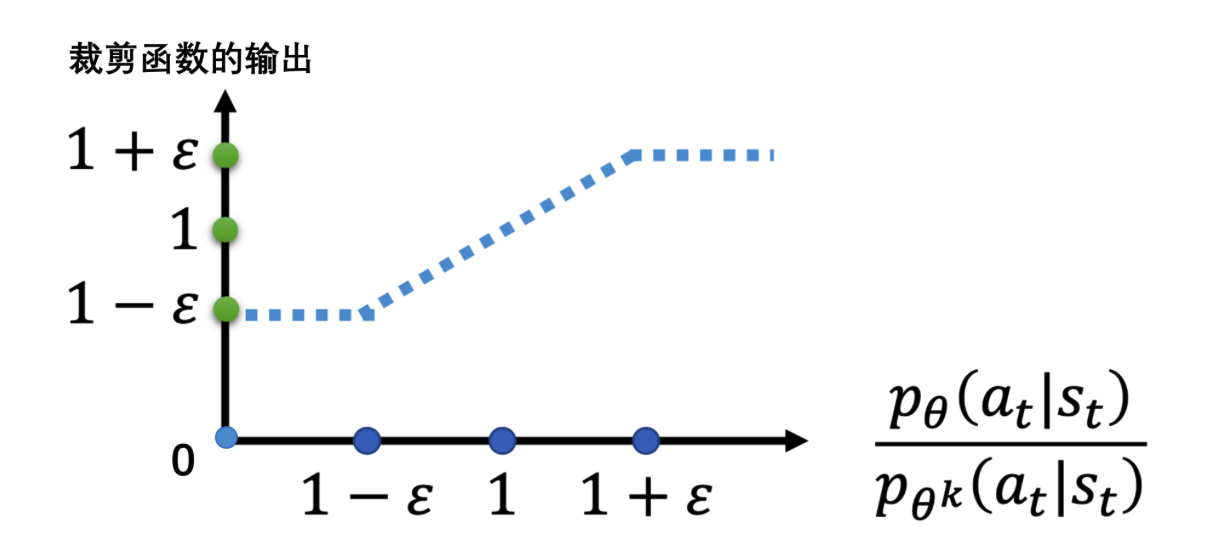
如图a所示,$\frac{p_{\theta}(a_t \mid s_t)}{p_{\theta'}(a_t \mid s_t)}$ 是绿线,$clip(\frac{p_{\theta}(a_t \mid s_t)}{p_{\theta'}(a_t \mid s_t)} ,1-\epsilon,1+\epsilon)$为蓝线。假设前面乘上的项$A$大于 0,取最小的结果,就是红色的这条线。如图 5.3b 所示,如果$A$小于 0 ,取最小结果的以后,就得到红色的这条线
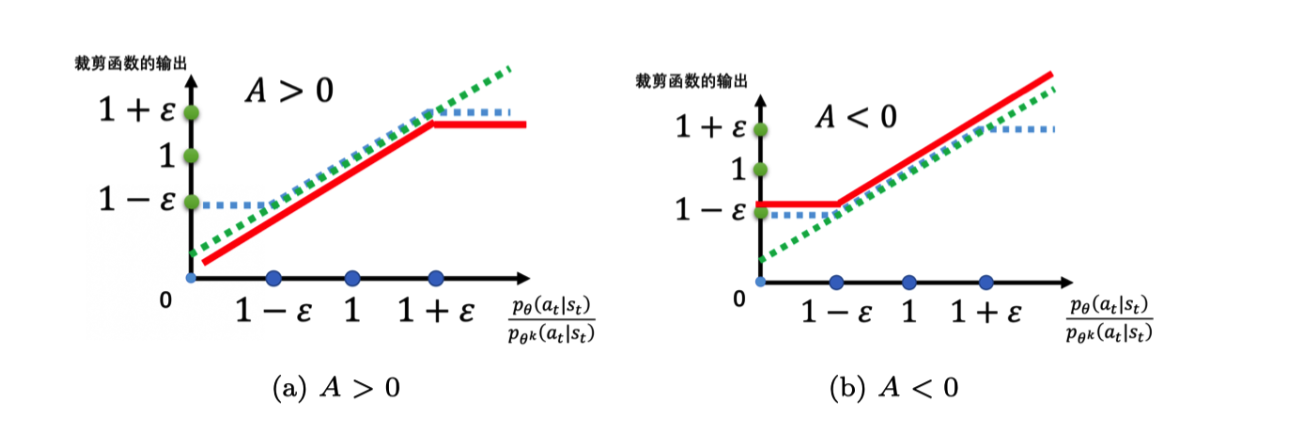
本质来说,我们希望$p_{\theta}(a_t \mid s_t)$和$p_{\theta^k}(a_t \mid s_t)$比较接近,也就是做示范的模型与实际上学习的模型在优化以后不要差距太大。