target 比较不同任务配置下,RBC(Rule-Based Control)与 RLC(Reinforcement Learning Control)在能源、排放、峰值与舒适度方面的表现。
Electricity Cost [$]
Emissions [kg CO₂]
Peak Demand [kW]
Discomfort Penalty [–]
准备环境 创建环境,准备citylearn的conda env
1
2
conda create -n citylearn python=3.10 -y conda activate citylearn
安装city learn V2
1
2
3
4
git clone https://github.com/intelligent-environments-lab/CityLearn.git cd CityLearn pip install -e . # 源码控制版,仅用于复现 pip install citylearn # 后续试验可以直接用这个下载
如果是macOS,pip install的时候会发生如下报错:
1
2
3
ERROR: Ignored the following versions that require a different python version: 2.3.0 Requires-Python >=3.11; 2.3.1 Requires-Python >=3.11; 2.3.2 Requires-Python >=3.11; 2.3.3 Requires-Python >=3.11; 2.3.4 Requires-Python >=3.11 ERROR: Could not find a version that satisfies the requirement openstudio<=3.3.0 (from citylearn) (from versions: 3.5.0, 3.5.1, 3.6.0, 3.6.1, 3.7.0rc1, 3.7.0, 3.8.0, 3.9.0, 3.10.0rc5, 3.10.0) ERROR: No matching distribution found for openstudio<=3.3.0
这是因为OpenStudio 只支持 x86 架构,Apple Silicon (arm64) 下没有编译版本,跳过依赖,自己手动安装
1
2
pip install -e . --no-deps pip install numpy==1.26.4 pandas pyyaml scikit-learn==1.2.2 simplejson torch torchvision gymnasium==0.28.1 nrel-pysam doe_xstock
这边建议还是用linux比较好,后续复现都基于Linux而非macOS,macOS的环境配置等我有空了再写(毕竟本地运行最方便)
目前macOS失败的原因:OpenStudio 不支持 macOS ARM 架构
进行测试 配置完环境之后,可以使用测试代码看看效果
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
from citylearn.citylearn import CityLearnEnv from pathlib import Path import numpy as np # 加载 CityLearn 环境 schema = Path('/root/CityLearn/data/datasets/citylearn_challenge_2021/schema.json') env = CityLearnEnv(schema=schema) print("✅ Env loaded successfully!") # 重置环境(Gymnasium 风格) obs, info = env.reset() # 打印建筑数量与ID print("✅ Number of buildings:", len(env.buildings)) # 打印每栋建筑的观测长度 obs_lens = [len(o) for o in obs] print("✅ Observation lengths per building:", obs_lens) # 示例:查看第一个建筑的前5个特征 print("✅ Sample observation (Building 1):", obs[0][:5]) # 如果要转换为矩阵,可以先对齐长度(取最短长度或补零) min_len = min(obs_lens) obs_array = np.array([o[:min_len] for o in obs]) print("✅ Converted obs array shape:", obs_array.shape)
有五个✅就ok了,输出结果应该如下:
1
2
3
4
5
6
7
(citylearnv2) root@autodl-container-491e4b9a34-9e5b11d5:~/CityLearn# python Untitled1.py Couldn't import dot_parser, loading of dot files will not be possible. ✅ Env loaded successfully! ✅ Number of buildings: 9 ✅ Observation lengths per building: [28, 27, 26, 27, 28, 28, 27, 27, 27] ✅ Sample observation (Building 1): [1, 4, 1, 9.4, 10.020000457763672] ✅ Converted obs array shape: (9, 26)
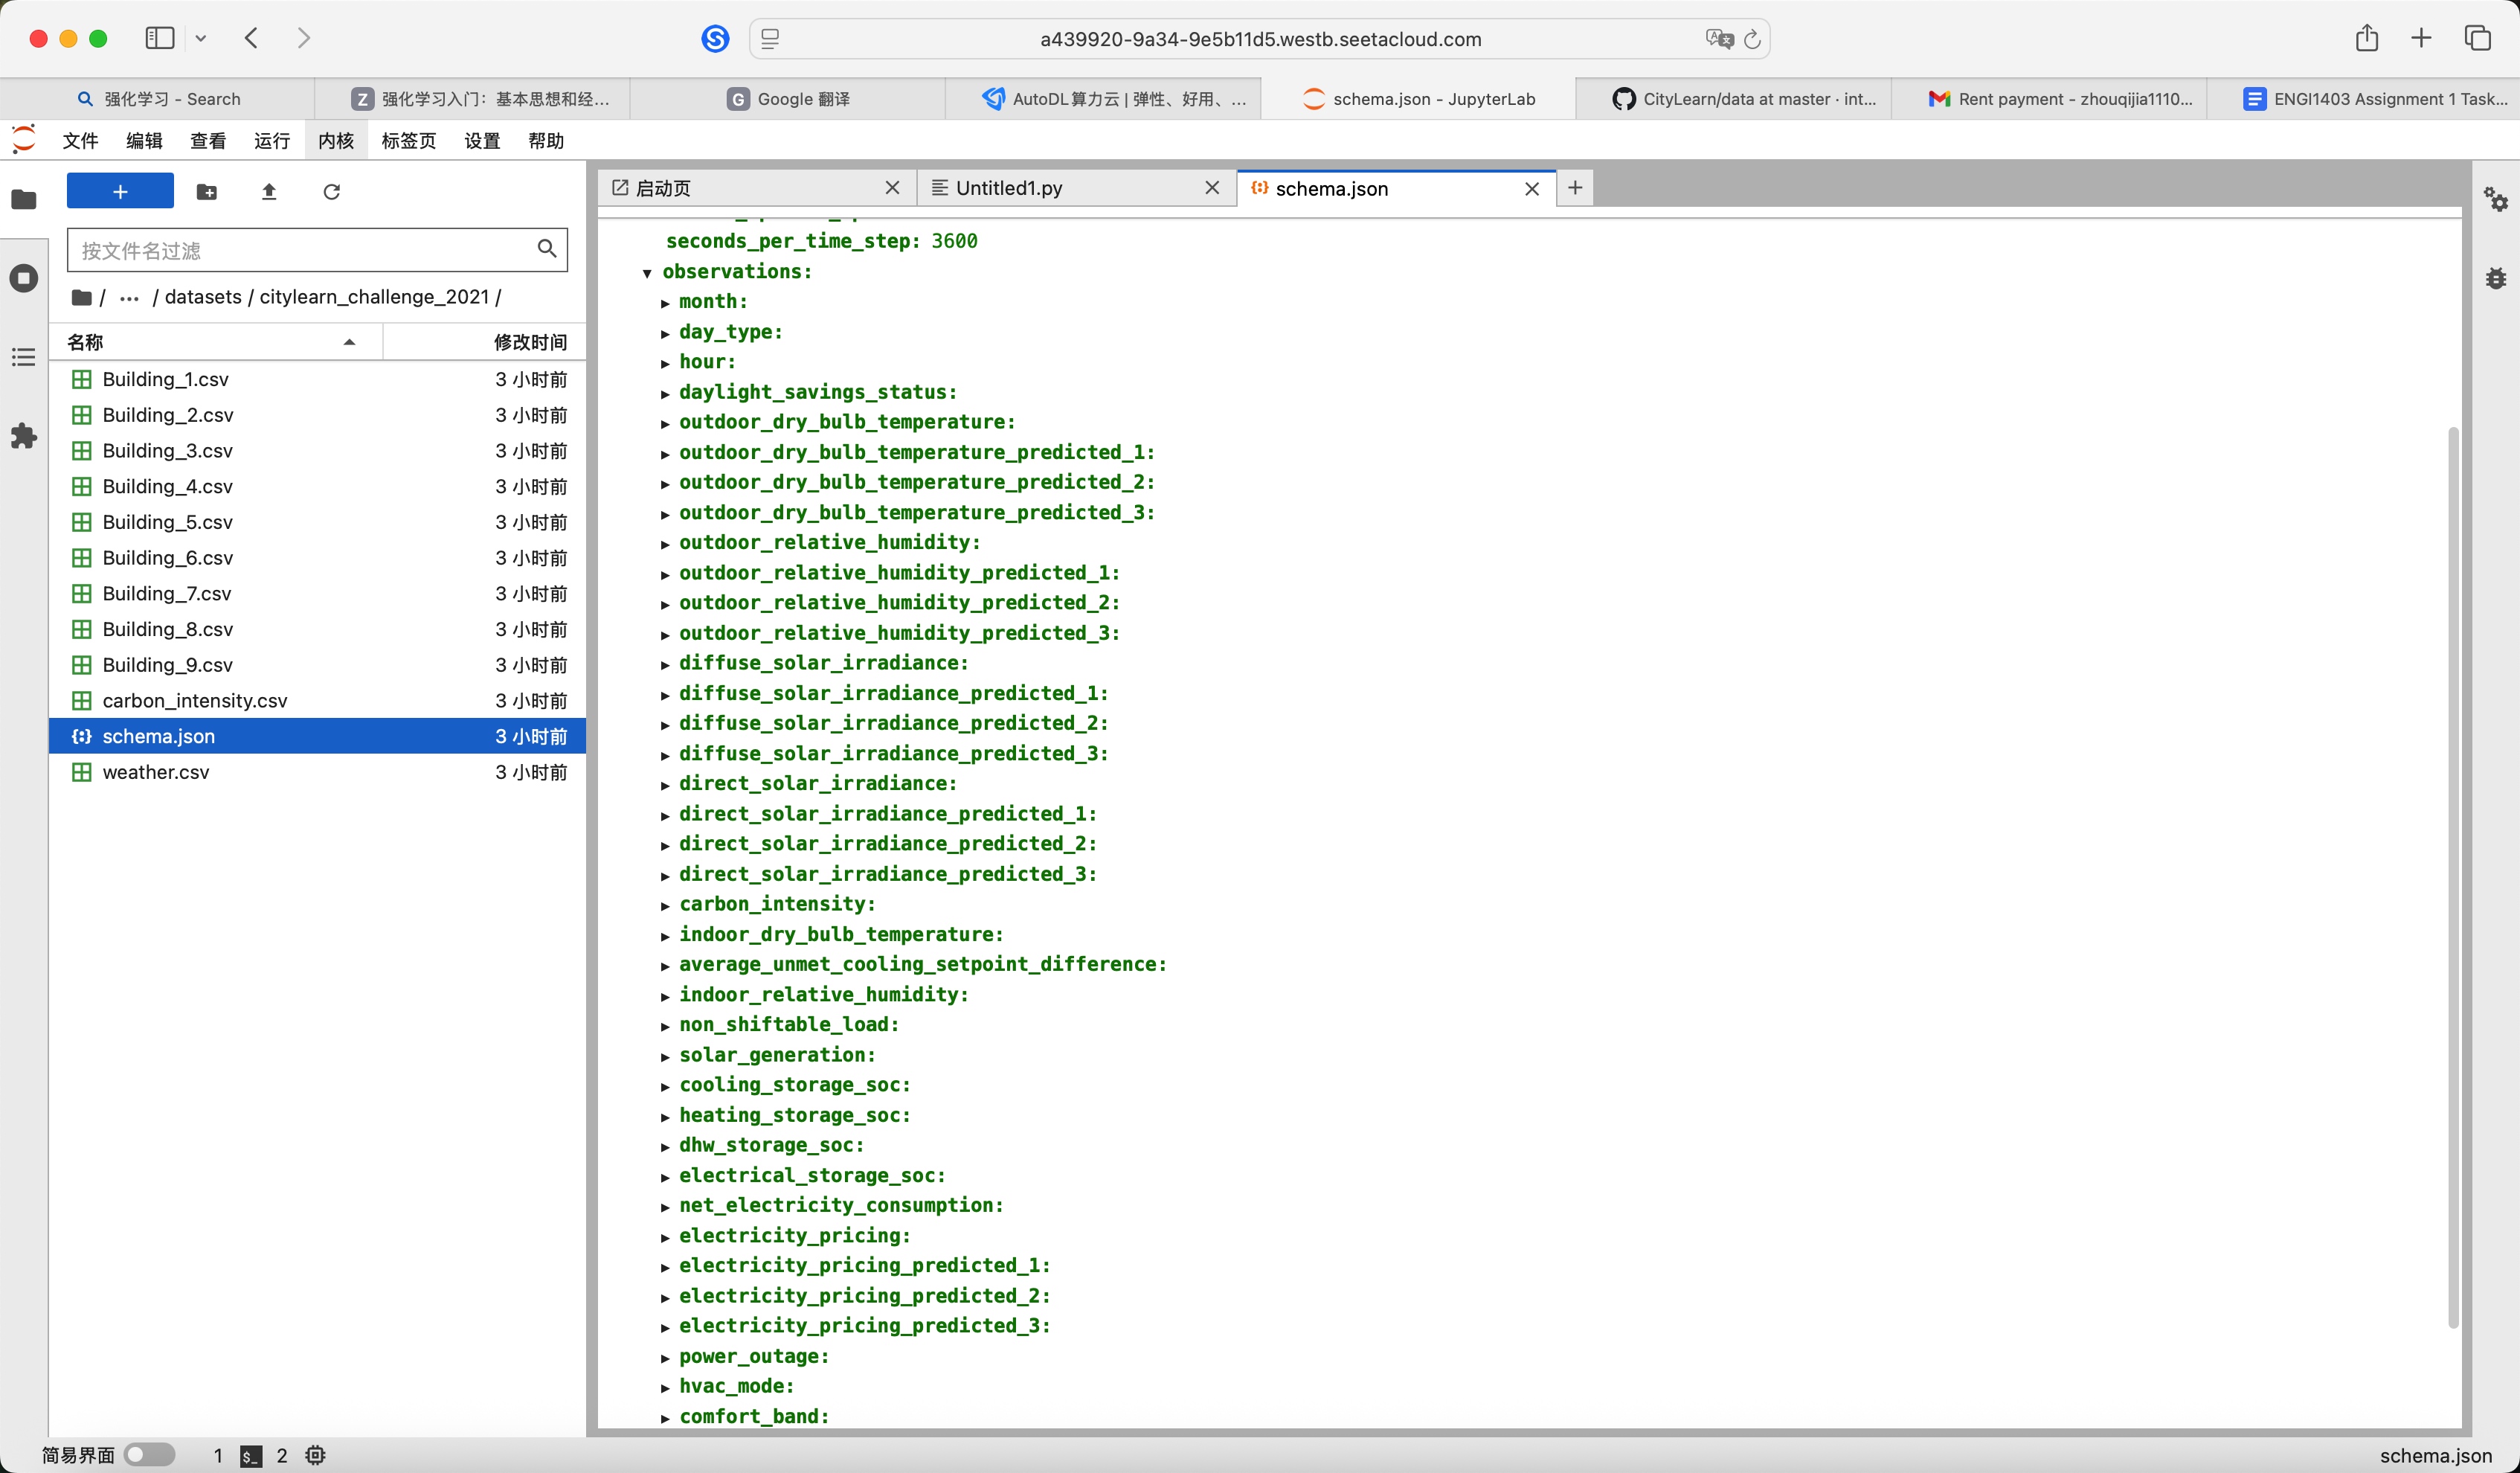
number of buildings 可以理解为agent的数量,每一个agent都是一个独立的智能体,共享天气、电价、碳排放等全局信息,共同学习协调策略
Control task distribution 该章节设计了 17 个不同的控制任务,对比 3 种控制方式 + 4 种控制目标。三种方法在代码中的本质区别就是reward不同,需要在传入 CityLearnEnv() 时,自定义Reward Function
1. Cost or Emission Reduction 以最小化电费成本或碳排放总量为KPI,进行三种方式的训练
1.1 实验设置 数据集: CityLearn Challenge 2023 (Phase 2 local evaluation)
1.2 环境 Baseline – 不做任何控制。
1.3 代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 from citylearn.citylearn import CityLearnEnv from citylearn.agents.base import BaselineAgent from citylearn.agents.rbc import BasicRBC from citylearn.agents.sac import SAC from pathlib import Path def run(agent_class, schema, episodes=1, central_agent=True, save_dir=None, **kwargs): print(f"\n=== Running {agent_class.__name__} ===") env = CityLearnEnv(schema, central_agent=central_agent) agent = agent_class(env) agent.learn(episodes=episodes, deterministic_finish=True) results = env.evaluate() env.close() print(f"✅ {agent_class.__name__} finished.") if save_dir: Path(save_dir).mkdir(parents=True, exist_ok=True) (Path(save_dir)/"metrics.txt").write_text(str(results)) return results def main(): # 使用本地数据集 schema schema = "data/datasets/citylearn_challenge_2023_phase_2_local_evaluation/schema.json" # 1 Baseline 无控制 res_base = run(BaselineAgent, schema, episodes=1, central_agent=True, save_dir="results/4_1_1_baseline") # 2 RBC 规则控制 res_rbc = run(BasicRBC, schema, episodes=1, central_agent=True, save_dir="results/4_1_1_rbc") # 3 SAC 强化学习控制 res_sac = run(SAC, schema, episodes=5, central_agent=False, save_dir="results/4_1_1_sac") # 输出对比结果 print("\n=== Comparison ===") print("Baseline:", res_base) print("RBC:", res_rbc) print("SAC:", res_sac) if __name__ == "__main__": main()
目的是在相同环境下,依次运行三种控制策略(Baseline → RBC → SAC),并保存结果。主体是run函数,就详细讲他了
初始化环境
1 env = CityLearnEnv(schema, central_agent=central_agent)
CityLearnEnv 是 CityLearn 的核心环境类,它根据 schema.json 读取城市能耗数据(建筑负荷、电价、太阳能、天气等)。
初始化智能体
1 agent = agent_class(env)
BaselineAgent:完全不做控制(仅被动执行环境动作)
训练智能体
1 agent.learn(episodes=episodes, deterministic_finish=True)
episodes:训练轮数(你给 Baseline/RBC 各 1 次,SAC 给 5 次)
评估结果
1 results = env.evaluate()
返回一个性能指标字典,如能耗、峰值负荷、碳排放、成本等
打印与保存
1.4 问题汇总 1.4.1 RBC(规则控制)的规则是什么?代码中怎么体现? RBC(Rule-Based Control)是 基于人工经验规则的控制策略。在 CityLearn 中,RBC 主要负责控制每栋建筑的储能设备(电池)何时充电、何时放电。
1.4.2. SAC(强化学习控制)用的是什么算法? SAC 是 Soft Actor-Critic)算法,基于最大熵强化学习(Maximum Entropy RL)的连续动作控制算法。就跟流程图中的一样,有三部分构成
1.4.3. RBC规则能否自定义 BasicRBC 是 CityLearn 自带的默认规则控制器(定义在 rbc.py)。但完全可以自定义自己的规则。只需继承基类并重写 select_actions()即可
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 from citylearn.agents.base import BaseAgent class MyRBC(BaseAgent): def select_actions(self, observations): actions = [] for obs in observations: price = obs['electricity_price'] soc = obs['storage_soc'] solar = obs['solar_generation'] if price < 0.05 and solar > 0: action = 1.0 # 加强充电 elif price > 0.2 or soc > 0.8: action = -1.0 # 放电 else: action = 0.0 actions.append(action) return actions run(MyRBC, schema, episodes=1, central_agent=True)
1.4.4. SAC 强化学习控制是否和问题3一样? 也可以和问题3一样,自定义,只要实现相同接口即可
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 from citylearn.agents.base import BaseAgent from stable_baselines3 import PPO class PPOAgent(BaseAgent): def __init__(self, env): super().__init__(env) self.model = PPO('MlpPolicy', env, verbose=1) def learn(self, episodes=1, **kwargs): self.model.learn(total_timesteps=episodes * len(self.env.time_steps)) def select_actions(self, observations): action, _ = self.model.predict(observations, deterministic=True) return action run(PPOAgent, schema, episodes=5, central_agent=False)
ps:schema文件中reward_function配置(具体在2.2中解释)
1 2 3 4 5 6 7 8 "reward_function": { "type": "citylearn.reward_function.RewardFunction", "attributes": { "electricity_cost_weight": 0.6, "emission_weight": 0.4, "peak_to_average_ratio_weight": 0.0 } }
2. Peak Reduction 以削减社区总功率峰值为KPI,进行三种方式的训练
2.1 环境 RBC 仍按规则上述运行
2.2 代码 4.1.2 节中明确指出,实验目标变为降低峰值负荷(district-level daily peak load)。文中说明:
而在 CityLearn 环境中,KPI 由 reward_function 控制。所以要把 4.1.1 的“cost / emission minimization” 改成 4.1.2 的“peak reduction”,只需在 schema.json 里修改 reward 配置即可。
1 2 3 4 5 6 7 8 9 "reward_function": { "type": "citylearn.reward_function.RewardFunction", "attributes": { "electricity_cost_weight": 0.0, "emission_weight": 0.0, "peak_to_average_ratio_weight": 1.0 } }
其他代码与4.1.1相同
3. Discomfort and Electricity Consumption Reduction KPI为在节能的同时维持舒适度(供暖、热水温度等)
3.1 代码 1 2 3 4 5 6 7 8 9 10 "reward_function": { "type": "citylearn.reward_function.ComfortReward", "attributes": { "band": 1.0, "lower_exponent": 2.0, "higher_exponent": 3.0, "m": 3.0, "mode": "cooling" } }
summary 在 4.1 部分的实验中,通过修改 schema.json 中的 reward_function 配置即可切换不同的性能评价指标(KPI)与控制目标,从而实现基于不同优化目标的策略训练
所有的reward_function可以在这看:
当然,以上仅针对SAC,如果是RBC,需要修改rbc.py文件里的策略,不过我觉得重点是SAC,所以暂且就先不管RBC的规则修改了
Energy storage system control in representative single-family neighborhoods 如果说4.1是多目标基准测试(环境固定,控制算法固定,KPI不同),那4.2就是不同建筑类型(如单层房、多层房、带太阳能的房屋)具有不同负荷特性与储能需求,同样的控制算法在这些“代表性住宅”上会表现出不同的能耗动态。
1. 重点
采用相同的 RL 控制策略(通常是 SAC);
在不同的 “representative neighborhoods” schema 上运行;
比较结果
2. 区别
3. 代码 和4.1其实大同小异,central_agent=False即可,突出各agent单独训练
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 # ============================================================ # CityLearn 4.2 实验复现: Energy storage system control # 参考论文 Section 4.2 # ============================================================ from citylearn.citylearn import CityLearnEnv from citylearn.agents.base import BaselineAgent from citylearn.agents.rbc import BasicRBC from citylearn.agents.sac import SAC from pathlib import Path from debug_sac import DebugSAC # ✅ 使用调试版本,不改库 # 测试用,仅使用n栋buildings def run(agent_class, schema, episodes=1, central_agent=False, save_dir=None): print(f"\n=== Running {agent_class.__name__} | Central Agent = {central_agent} ===") # ✅ 正确选择前三栋建筑 env_full = CityLearnEnv(schema, central_agent=central_agent) selected_buildings = env_full.buildings[:20] env_full.close() # ✅ 用3栋建筑创建新环境 env = CityLearnEnv(schema, buildings=selected_buildings, central_agent=central_agent) env.reset() agent = agent_class(env) agent.learn(episodes=episodes, deterministic_finish=True) results = env.evaluate() env.close() print(f"✅ {agent_class.__name__} finished.") print(f"📊 Results: {results}") if save_dir: Path(save_dir).mkdir(parents=True, exist_ok=True) (Path(save_dir) / "metrics.txt").write_text(str(results)) return results # def run(agent_class, schema, episodes=1, central_agent=False, save_dir=None): # print(f"\n=== Running {agent_class.__name__} | Central Agent = {central_agent} ===") # # ✅ 创建环境 # env = CityLearnEnv(schema, buildings=env.buildings[:3], central_agent=False) # # env = CityLearnEnv(schema, central_agent=central_agent) # env.reset() # # ✅ 创建 Agent # agent = agent_class(env) # # ✅ 训练 Agent(Baseline / RBC 会自动跳过 learn) # agent.learn(episodes=episodes, deterministic_finish=True) # # ✅ 评估指标 # results = env.evaluate() # env.close() # print(f"✅ {agent_class.__name__} finished.") # print(f"📊 Results: {results}") # # ✅ 保存结果 # if save_dir: # Path(save_dir).mkdir(parents=True, exist_ok=True) # (Path(save_dir) / "metrics.txt").write_text(str(results)) # return results def main(): schema = "data/datasets/ca_alameda_county_neighborhood/schema.json" central_agent = False # Baseline run( agent_class=BaselineAgent, schema=schema, episodes=1, central_agent=central_agent, save_dir="results/4_2_baseline_CA" ) # RBC run( agent_class=BasicRBC, schema=schema, episodes=1, central_agent=central_agent, save_dir="results/4_2_rbc_CA" ) # SAC run( agent_class=DebugSAC, schema=schema, episodes=5, central_agent=central_agent, save_dir="results/4_2_sac_CA" ) if __name__ == "__main__": main()
4. 报错 4.1 AssertionError 1 AssertionError: demand is greater than heating_device max output | timestep: 0, building: resstock-amy2018-2021-release-1-122940, outage: False, demand: 3.1614, output: 2.9663, difference: 0.1950
CityLearn 在 building.py 里写了安全检查,类型如下
可以打开citylearn/building.py
1 2 3 4 5 6 7 # before assert self.power_outage or demand <= max_device_output or abs(demand - max_device_output) < TOLERANCE, \ f"demand is greater than heating_device max output | ..." # now if not (self.power_outage or demand <= max_device_output or abs(demand - max_device_output) < TOLERANCE): print(f"[Warning] demand > heating_device max output at timestep {self.time_step}")
或者跑代码的时候直接python -O run_4_2.py(忽略所有 assert 语句)
或者把容忍度从1e-4改大一些也行
但是总体而言问题不大,论文里说了,在基于 ResStock 的建筑数据中,由于缩放差异,初始化时可能会出现轻微的设备容量超限,这不会影响实验结果。
4.2 TypeError: new(): data must be a sequence (got NoneType) 先看报错内容
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 (citylearnv2) root@autodl-container-491e4b9a34-9e5b11d5:~/CityLearn# python -O run_4_2.py Couldn't import dot_parser, loading of dot files will not be possible. === Running SAC === Traceback (most recent call last): File "/root/CityLearn/run_4_2.py", line 44, in <module> main() File "/root/CityLearn/run_4_2.py", line 40, in main run(SAC, schema, episodes=5, central_agent=central_agent, File "/root/CityLearn/run_4_2.py", line 16, in run agent.learn(episodes=episodes, deterministic_finish=True) File "/root/CityLearn/citylearn/agents/base.py", line 156, in learn actions = self.predict(observations, deterministic=deterministic) File "/root/CityLearn/citylearn/agents/sac.py", line 189, in predict actions = self.get_post_exploration_prediction(observations, deterministic) File "/root/CityLearn/citylearn/agents/sac.py", line 206, in get_post_exploration_prediction o = torch.FloatTensor(o).unsqueeze(0).to(self.device) TypeError: new(): data must be a sequence (got NoneType)
常见成因如下
初始化观测没准备好
schema 的观测被关了
观测形态不匹配
PS:太他妈变态了这个问题,这个error卡了我将近一周才知道哪里出现了问题
解决方法(过于变态,我选择讲我怎么解决的)
从数据集入手
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 # inspect_schema.py import json, sys, argparse, os from typing import Any, Dict, List def load_schema(path: str) -> Dict[str, Any]: txt = open(path, 'r', encoding='utf-8').read() # 先尝试 JSON try: data = json.loads(txt) except Exception: # 可选:YAML(若安装了 PyYAML) try: import yaml # pip install pyyaml data = yaml.safe_load(txt) except Exception as e: print(f"❌ 既不是 JSON 也不是可解析的 YAML:{e}") sys.exit(1) # 大多数 CityLearn schema 顶层有个 'root' return data.get('root', data) def main(): ap = argparse.ArgumentParser() ap.add_argument('--schema', required=True, help='path/to/schema.json') args = ap.parse_args() sc = load_schema(args.schema) print("\n=== Top-level keys ===") print(list(sc.keys())) # 1) central_agent & sim period print("\n=== Simulation/Agent ===") print("central_agent:", sc.get('central_agent')) print("simulation_start_time_step:", sc.get('simulation_start_time_step')) print("simulation_end_time_step:", sc.get('simulation_end_time_step')) print("seconds_per_time_step:", sc.get('seconds_per_time_step')) # 2) observations(全局) obs = sc.get('observations', {}) print("\n=== Global Observations ===") if not obs: print("⚠️ observations 是空的(这会导致 SAC 观测为 None)") else: actives = [k for k,v in obs.items() if isinstance(v, dict) and v.get('active', False)] inactives = [k for k,v in obs.items() if isinstance(v, dict) and not v.get('active', False)] print("active 数量:", len(actives)) print("active 列表(前20):", actives[:20]) if inactives: print("inactive 列表(前20):", inactives[:20]) # 3) buildings(字典或列表) b = sc.get('buildings', {}) print("\n=== Buildings ===") if isinstance(b, dict): b_names = list(b.keys()) print("建筑数量:", len(b_names)) sample = b_names[:5] print("示例建筑:", sample) # 检查 include / inactive_observations problem_buildings: List[str] = [] fully_inactive: List[str] = [] for name in b_names: cfg = b[name] or {} include = cfg.get('include', True) if not include: problem_buildings.append(name) inact = cfg.get('inactive_observations', []) # 如果把全局 active 都屏蔽了,也会导致该建筑 obs=None try: actives = [k for k,v in obs.items() if isinstance(v, dict) and v.get('active', False)] if actives and isinstance(inact, list) and set(inact) >= set(actives): fully_inactive.append(name) except Exception: pass if problem_buildings: print(f"⚠️ 有 {len(problem_buildings)} 栋建筑 include=false(可能导致 None):", problem_buildings[:5]) if fully_inactive: print(f"⚠️ 有 {len(fully_inactive)} 栋建筑把所有全局观测都屏蔽了:", fully_inactive[:5]) else: print("⚠️ buildings 不是字典(请贴内容我再看)") # 4) 快速“环境探针”(不训练,只 reset 看看 obs 形态) try: from citylearn.citylearn import CityLearnEnv ca = sc.get('central_agent', False) print("\n=== Env probe (reset) ===") env = CityLearnEnv(args.schema, central_agent=ca) obs0 = env.reset() print("reset() 返回类型:", type(obs0)) if obs0 is None: print("❌ reset() 返回 None —— SAC 会在 FloatTensor(None) 处报错。") else: try: # centralized → 向量/数组;decentralized → list[数组] if isinstance(obs0, list): shapes = [getattr(x, 'shape', None) for x in obs0] print("分布式观测数量:", len(obs0), "示例形状:", shapes[:5]) else: print("集中式观测形状:", getattr(obs0, 'shape', None)) except Exception: pass env.close() except Exception as e: print("(可选探针失败:)", e) if __name__ == '__main__': main()
进行调试
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 import numpy as np import torch from citylearn.agents.sac import SAC class DebugSAC(SAC): """调试用 SAC:不改原库,但打印 observation & None 来源""" def get_post_exploration_prediction(self, observations, deterministic=False): # ✅ 如果是 dict,先转换为 list,避免原始错误 if isinstance(observations, dict): observations = [obs for obs in observations.values()] actions = [] for i, o in enumerate(observations): # ✅ Debug:打印原始 obs print(f"\n🔍 [Debug] Building {i} raw obs = {o}") if o is None: raise ValueError(f"❌ Observation from agent {i} is None (raw environment output)") # ✅ 编码 encoded = self.get_encoded_observations(i, o) print(f" ➤ Encoded obs = {encoded}") if encoded is None: raise ValueError(f"❌ get_encoded_observations() returned None for agent {i}") # ✅ 归一化 normalized = self.get_normalized_observations(i, encoded) print(f" ➤ Normalized obs = {normalized}") if normalized is None: raise ValueError(f"❌ get_normalized_observations() returned None for agent {i}") # ✅ 尝试转成 tensor try: o_tensor = torch.FloatTensor(normalized).unsqueeze(0).to(self.device) except Exception as e: print(f"❌ Failed to convert obs to tensor. Obs = {normalized}") raise e # ✅ 原来的 action 获取流程 result = self.policy_net[i].sample(o_tensor) a = result[2] if deterministic else result[0] actions.append(a.detach().cpu().numpy()[0]) return actions
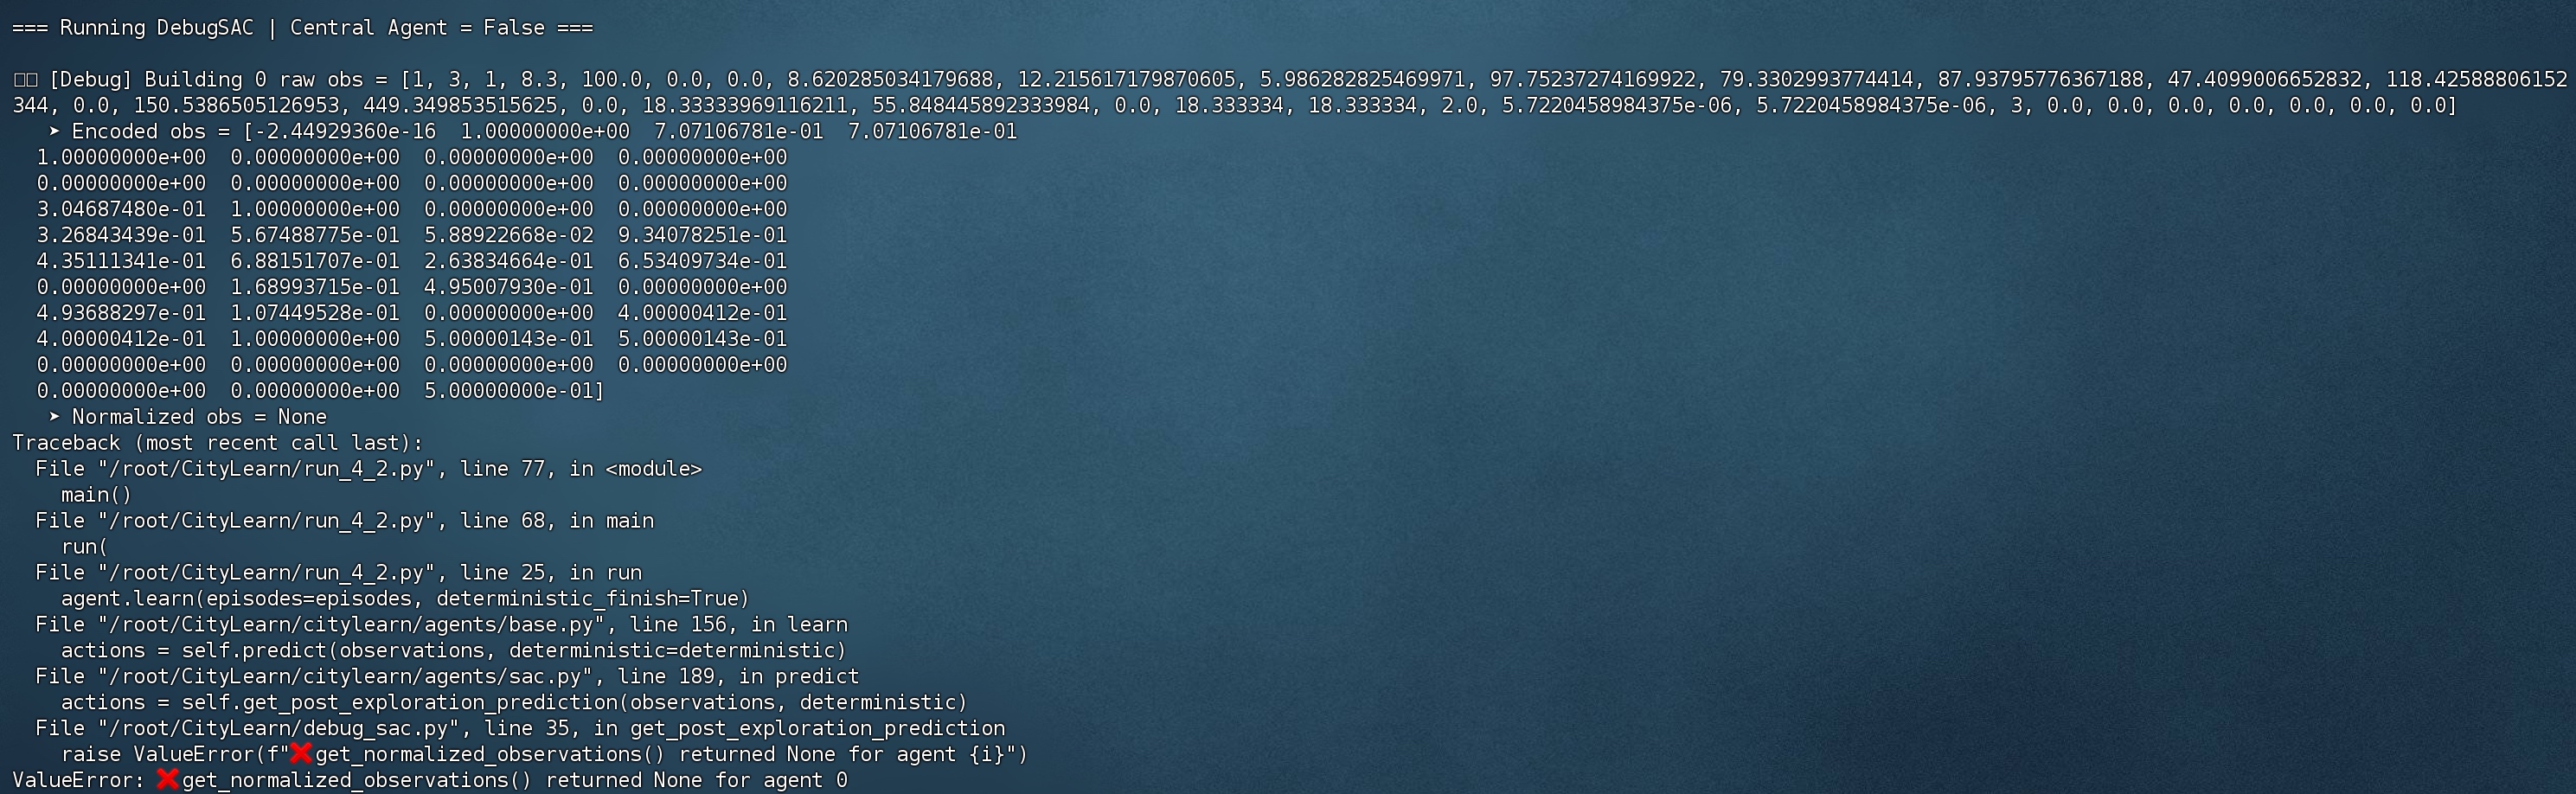
把步骤分开,终于!找到了问题所在–normalized,为什么会有这个问题呢?reason:
normalization_enable 默认是 True
但 normalization 参数(mean/std)只会在训练若干步后才更新
第 1 个 timestep 直接调用 predict() → normalization 矩阵还没有 → 返回 None
soluation
在训练前自动收集数据,初始化 mean/std
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 # 初始化 normalization obs_buffer = [] obs = env.reset() for _ in range(500): # 收集前 500 步 action = env.action_space.sample() # 随机动作 obs, _, _, _ = env.step(action) obs_list = list(obs.values()) if isinstance(obs, dict) else obs obs_buffer.extend(obs_list) obs_buffer = np.array(obs_buffer) agent.obs_mean = np.mean(obs_buffer, axis=0) agent.obs_std = np.std(obs_buffer, axis=0) + 1e-6 # 避免除0 print("✅ Normalization initialized.")
中途动态归一化
summary 4.1 是算法在不同 KPI 下的“目标函数对比实验”;
Vehicle-to-Grid Control 1. 重点与目标 在 CityLearn 环境中扩展强化学习模型,使得电动汽车不仅能充电,还能在高峰时段将电能回馈给建筑或电网,以实现削峰填谷和整体能耗优化,目标如下
将 V2G 机制引入智能电网中的多建筑控制框架;
探究 RL 智能体如何在建筑储能系统与电动汽车电池之间协调能量流动;
目标函数不仅考虑电费最小化,还考虑排放、峰值负荷和舒适度约束。
2. 环境设置 在 CityLearn 环境中,每栋建筑不仅有battery储能系统,还额外配置EV battery,RL 智能体的动作空间包括:
$$
a_t = \left[ a_{\text{building battery}},\ a_{\text{EV battery}} \right]
$$
其中每个$a_t$ 都表示充/放电比例;
EV 的可用时间窗口 由住宅用户行为数据确定(车辆通常白天离家、夜晚接入电网);
充电功率受限于$P_{\max}$ ,同时遵守SoC上下界约束;
动作经过归一化与裁剪,保证物理可行性。
3. 奖励函数 典型形式为:
$$
r_t = -\alpha C_t - \beta E_t - \gamma P_{\text{peak},t}
$$
where
$C_t$ :用电成本;$E_t$ :碳排放;$P_{\text{peak},t}$ :峰值功率;$\alpha, \beta, \gamma$ :权重系数。
4. 区别
一句话概括就是,4.3在RL基础上进一步扩展到“建筑 + 电动车”双储能控制,即 Vehicle-to-Grid (V2G)
5. 代码 以4.1的SAC部分为baseline,如下
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 from citylearn.citylearn import CityLearnEnv from citylearn.agents.sac import SAC from pathlib import Path def run_v2g(agent_class, schema, episodes=3, central_agent=False, save_dir=None, **kwargs): print(f"\n=== Running {agent_class.__name__} (Vehicle-to-Grid) ===") # ✅ 启用 include_evs / v2g 参数 env = CityLearnEnv(schema, central_agent=central_agent, include_evs=True, **kwargs) agent = agent_class(env) agent.learn(episodes=episodes, deterministic_finish=True) results = env.evaluate() env.close() print(f"✅ {agent_class.__name__} (V2G) finished.") if save_dir: Path(save_dir).mkdir(parents=True, exist_ok=True) (Path(save_dir)/"metrics.txt").write_text(str(results)) return results def main(): # ✅ 使用含 EV battery 的 V2G 版本 schema schema_v2g = "data/citylearn_challenge_2022/v2g_schema.json" # ✅ 运行 SAC 控制器(Vehicle-to-Grid 实验) res_v2g = run_v2g(SAC, schema_v2g, episodes=5, central_agent=False, save_dir="results/4_3_v2g_sac") print("\n=== V2G SAC Results ===") print(res_v2g) if __name__ == "__main__": main()
Occupant comfort feedback during automated demand response 貌似复现不出来,因为这是一个基于CityLearn的EULP数据 + Ecobee DYD 的真实用户统计模型,
1. 目的 研究在自动化需量响应(Automated Demand Response, ADR)期间引入住户舒适度反馈机制对整体电力负载与控制性能的影响。
环境配置
对比