transformer架构
总流程
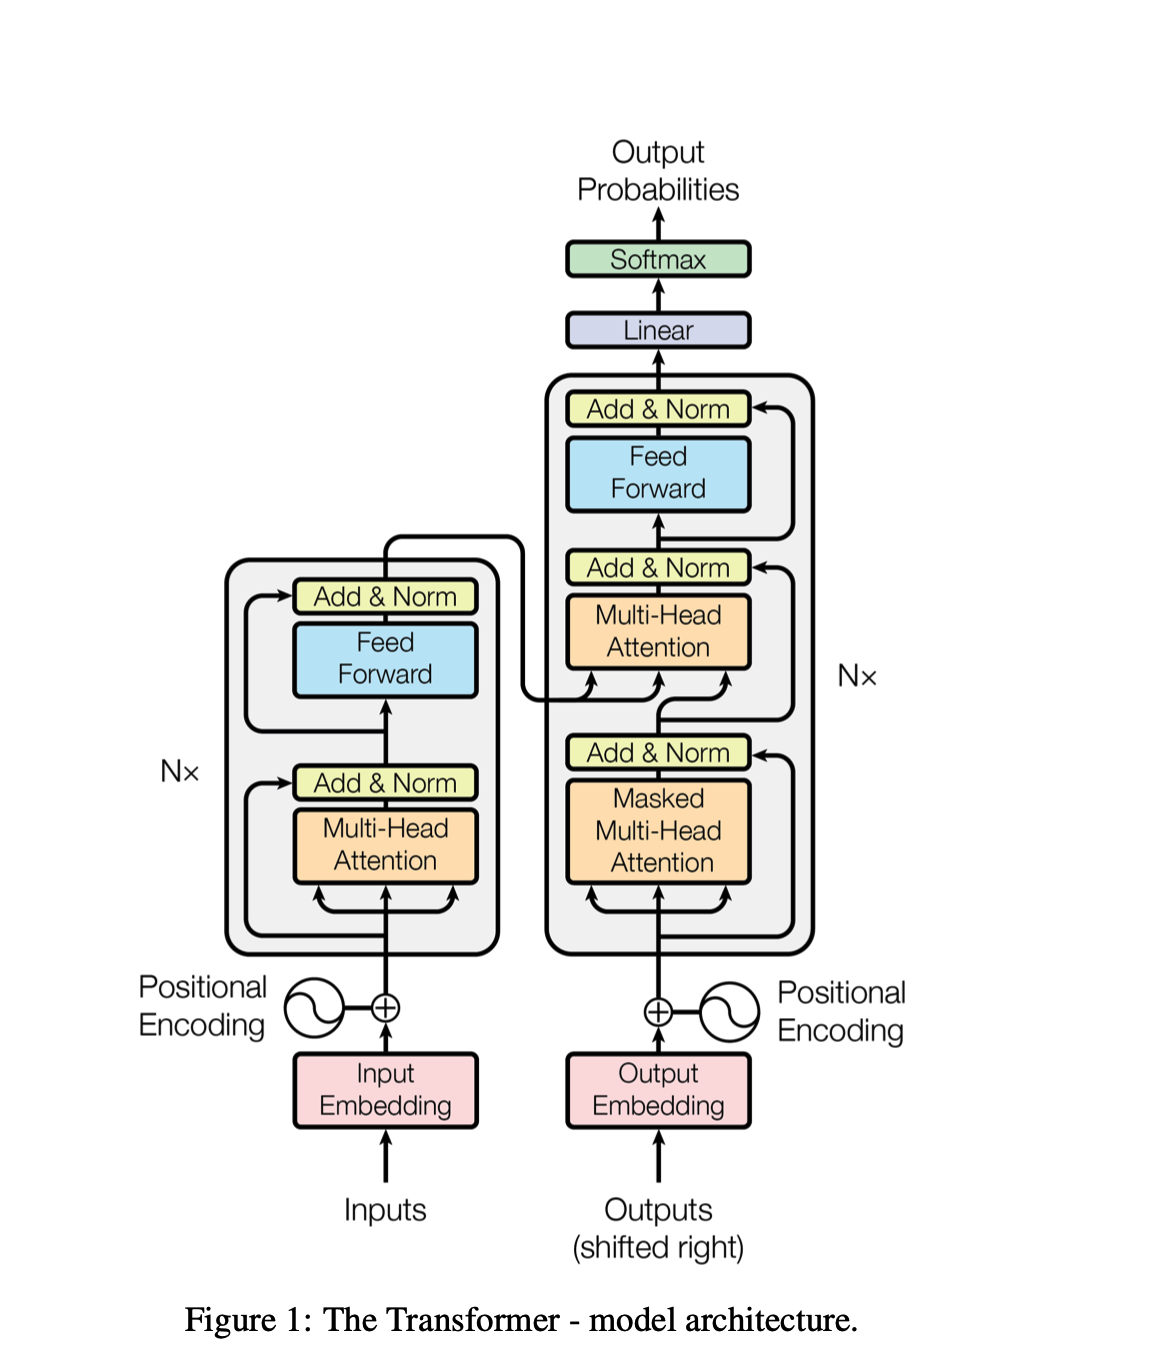
encoder层
目的
做完形填空,如‘我今天[MASK]了一碗面’.encoder通过双边注意力来猜测mask是什么
1. inputs & input embedding
单纯的查表,将每个token拆为表中所含的数字,随后通过id进行组合得到矩阵E(embedding)
| ID | 词 | 向量 |
|---|---|---|
| 0 | 我 | [0.2, -0.5, 0.9] |
| 1 | 爱 | [0.7, 0.1, -0.3] |
| 2 | 学习 | [-0.4, 0.8, 0.6] |
| 3 | 吃饭 | [0.6, 0.2, -0.1] |
原文的d_model = 512,实际可能很大如qwen
八股点:
- 原论文会把 Embedding 乘以 √d_model,目的是让它的数值量级和后面加上的位置编码相当。
- 输出端的 Linear 层常和 Embedding 共享同一个矩阵(weight tying),可以省参数。
- 为什么不用 one-hot?因为维度太高、太稀疏,而且任意两个词都正交,体现不出语义上的相似。
2. ⊕ & Positional Encoding
‘我爱你’和’你爱我’本质有区别,因此需要加上位置向量,原文用正弦余弦函数
PE(pos, 2i) = sin( pos / 10000^(2i/d) )
PE(pos, 2i+1) = cos( pos / 10000^(2i/d) )
pos:词在句子里的位置,0, 1, 2, …
d:向量维度(d_model),原论文里是 512
2i 和 2i+1:向量里第几维。i 从 0 取到 d/2−1,每个 i 管一对维度:第 2i 维放 sin,第 2i+1 维放 cos
10000^(2i/d):这一对维度的「波长系数」。i 越大,这个数越大,pos 除以它之后变化就越慢
八股点:
- 现在大模型一般不实用正余弦函数,用RoPE
3. Multi-Head Attention
3.1 单头注意力
让每个词去「看」句子里的其他词,根据相关程度,把别的词的信息融合进来
Step1: 生成 Q、K、V,输入(input) X 乘上三个可学习的矩阵(d*d_k)
Step2: 算相关度分数,S = Q·Kᵀ,S为二维数组,表示词i对词j有多关注
Step3:缩放,S / √d_k
Step4: Softmax,得到注意力权重,每一行加起来为1
Step5:加权求和,第 i 个词的新向量,就是所有词的 V 按权重加起来的结果
3.2 多头注意力
一套 Q、K、V 只能学到一种「关注方式」。但词和词之间的关系有很多种,比如语法关系、指代关系、相邻关系。所以做法是:并行地做 h 组注意力,每组有自己的 W_Q、W_K、W_V,各自学一种关系。
Step1: 每个头的维度 d_k = d/h = 64
Step2: 8 个头各自算出一个 n×64 的结果
**Step3:**把它们拼接(concat)起来,变回 n×512
**Step4:**再乘一个输出矩阵 W_O(512×512),把各个头的信息融合在一起
八股点:
- Q 表示「我想找什么」,K 表示「我能被什么找到」,V 表示「我实际提供的内容」
- Step3缩放,d_k 越大,点积的数值就越大,Softmax 会变得极端(一个接近 1,其余接近 0),梯度几乎消失。除以 √d_k 可以把方差拉回到 1 左右。
- 为什么用softmax,因为要的是每个词分配给其他词的注意力比例,天生就是概率问题
- 多头注意力的参数量是 4·d²,也就是 W_Q、W_K、W_V、W_O 四个 d×d 矩阵
4. Add & Norm
残差连接:输入放在输出上
防止梯度消失:模型有很多层。反向传播时,梯度可以沿着「+X」这条捷径直接往回传,不用每一层都穿过复杂的计算,深层网络才训练得动。
只学「改动量」:子层不需要从头构造整个表示,只需要学「在原来基础上要改什么」。如果某一层没用,它的输出接近 0 就行,原来的信息不会丢失
归一化:每层叠加之后,数值可能越来越大或越来越小,导致训练不稳定。把它拉回「均值 0、方差 1」附近,训练更稳、收敛更快。
八股点:
1. 为什么用 LayerNorm,而不是 BatchNorm?
- BN 是在一个 batch 内,对同一个特征跨样本做归一化;LN 是对同一个词的所有特征做归一化。
- 文本的长度不一样,batch 里还有 padding,跨样本统计会很乱,而且推理时 batch 可能只有 1。LN 只看自己,不依赖 batch,所以更适合 NLP。
2. Post-LN 和 Pre-LN
- 原论文是 Post-LN:LN(X + Sublayer(X)),先相加,再归一化。
- 现在的大模型普遍用 Pre-LN:X + Sublayer(LN(X)),先归一化,再进子层,残差这条路上不做任何处理。
- Pre-LN 的梯度更稳,深层模型不需要很长的 warmup 也能训练。Post-LN 的效果上限可能略高,但不好训。
3. RMSNorm(Llama、Qwen 使用)
只除以均方根,不减均值、也不加 β:x / √(mean(x²) + ε) · γ。
计算更省,效果和 LN 差不多,所以现在的大模型基本都用 Pre-RMSNorm。
5. Feed Forward
FFN提供非线性,为什么先升维再降维:在高维空间里,更容易把不同的特征分开、组合,然后再压缩回去
八股点:
- 参数量:2 × d × 4d = 8d²,是注意力(4d²)的 2 倍。模型大约 2/3 的参数都在 FFN 里。
- 激活函数的演进:原论文 ReLU → BERT/GPT 用 GELU(更平滑)→ Llama、Qwen 用 SwiGLU:多加一个门控矩阵,FFN(x) = (Swish(xW₁) ⊙ xW₃)·W₂。因为多了一个矩阵,中间维度通常改成约 8d/3,让总参数量和原来差不多。
- MoE(混合专家):把一个大 FFN 换成很多个小 FFN(专家),每个词只挑其中几个来计算。总参数量很大,但每次计算量很小。Qwen-MoE、DeepSeek 都采用这种结构。
代码
1. inputs & input embedding
1 | import math |
1. 1
在初始化中需要创建vocab_size × d_model 的 Embedding 表。其中vocab_size为字典长度,d_model为每个 token 向量的维度(默认512),以d_model=4为例
1 | ID 0 "i" → [ 0.2, -1.1, 0.5, 0.9] |
1.2
给一批句子(B = 2)
1 | ids = [[0, 1, 2], ← 第 1 句 "i like reading" |
形状为[B, N] = [2, 3],查表后每个id变成为4维,所以是[B, N, d]。最后乘以 √d_model,把词向量数值放大,避免之后加上位置编码时词本身的信息被盖过去。
自测
1 | if __name__ == "__main__": |
2. ⊕ & Positional Encoding
1 | import math |
在原有基础上加位置编码的值,所以输入与输出的shape一致
2.1
注意算的是2i而不是i。这和奇数偶数无关
2.2
算分母即可
2.3
维度不同会自动广播,无需在意。pe就是位置编码,需要相加
2.4
n的目的是只需要n个句子的位置编码即可
自测
1 | # ============ 自测:不要修改 ============ |
3. Head Attention
先看单头注意力,多头只需要把d_model平均分即可
1 | import math, torch, torch.nn as nn |
3. 1
init中Linear参数为shape,forward里为拿x乘这个矩阵
3.2
K.transpose(-2, -1)就是.T
最后一维的n为:词 i 看所有词
中间维的n为:所有词看词 j
接着是多头
1 | class MultiHeadAttention(nn.Module): |
4.1
Step1: 计算Q,K,V值
Step2: 每个词的 4 个数切成 2 个头 × 2 个数,就是把d_model切等分,每一分传给后续的注意力头
Step3: 交换第 1 维(n)和第 2 维(h)
4.4
切完的拼回去
4.5
W_o 是一个 d → d 的 Linear。输出的每个数都是输入 8 个数的加权和,所以每个输出都同时用到了两个头的结果
FFN
1 | class FeedForward(nn.Module): |
5.1
原输入先升维,再降维
Add & Norm
这部分看理论即可
1 | class TransformerBlock(nn.Module): |
Nx
1 | class Encoder(nn.Module): |
decoder层
目的
如果说encoder层的目的是理解词在这句话的意思(转化为b,n,d向量),decoder的目的是为了预测整个词表中,每个词作为下一个词出现的概率为多大
1. outputs(shifted right) & output embedding
首先把目标句子整体往右挪一格,最前面补一个开始符
1 | 目标句子: I love you </s> |
Decoder 拿「右移后」的序列当输入,用原来的目标句子当答案
1 | 位置: 0 1 2 3 |
如果不右移,模型看到的就是答案,再配合mask即可在不看到答案的情况下预测
embedding层相同
八股:
- 原论文里 Input Embedding、Output Embedding 和最顶上的 Linear 层共用同一张表(权重共享),能省很多参数
2. ⊕ & Positional Encoding
基本相同,唯一的区别只是长度:Encoder取前 n 行(原文长度),Decoder 这边取前 m 行(目标句子长度)
Masked Multi-Head Attention
让每个位置只能关注自己和之前的位置,看不到之后的。做法是在softmax之前,把后面的改为-inf
1 | <s> I love you |
经过softmax之后,后面就是0
1 | <s> [[ 1.00, 0, 0, 0 ], |
八股:
- Decoder 为什么要用 Masked Self-Attention?保证自回归:预测第 t 个词时只能看前面的词。训练时整句并行输入,不遮就会看到答案(信息泄露),mask 让训练和推理一致
- mask 为什么在 softmax 之前、设成 -∞?softmax 后再置 0,每行和不为 1;softmax 前设 -∞,e^(-∞)=0,剩余位置自动重新归一化
- Transformer 里有哪几种 mask?Padding mask(遮填充位,Encoder/Decoder 都用)和 Causal mask(遮未来位,只在 Decoder 自注意力用)
3. Multi-Head Attention(cross-Attention)
交叉注意力Q来自decoder,K,V来自encoder
- Q 来自 Decoder(上一层 Masked 自注意力的输出):「我正在生成这个词,需要原文的什么信息?」
- K、V 来自 Encoder 的最终输出:「原文每个词的标签和内容」
1 | Q: [B, m, d] K、V: [B, n, d] |
八股:
- 交叉注意力中 Q、K、V 分别来自哪里
- 交叉注意力需要因果 mask 吗?为什么?不需要。mask 是为了防止看到未来的目标词,而 K、V 来自原文,原文在生成前就完整已知,不存在「未来」。只在有填充时需要 padding mask
- 自注意力和交叉注意力的区别:自注意力的 Q、K、V 来自同一个序列,用于建模序列内部关系;交叉注意力的 Q 来自一个序列、K/V 来自另一个序列,用于建模两个序列之间的关系。
4. 其他一样
5. Linear + Softmax
decoder输出的shape为[B, m, d]。一个位置为d维向量,但不是词语,只是embedding后的结果,需要通过概率计算
1. Linear:d → V(V = 词表大小)
1 | [B, m, d] → Linear(d, V) → [B, m, V] |
每个位置得到 V 个分数(叫 logits),第 k 个分数表示「下一个词是词表第 k 个词」的可能性,还不是概率,可正可负。
例:词表有 3 万个词,每个位置就输出 3 万个分数。
2. Softmax:分数 → 概率
对最后一维(V)做 softmax,每个位置的 V 个数变成加起来等于 1 的概率分布。
1 | 位置 1(已看到 "<s> I"): |
3. 选词
- 训练时:不选词,直接用这个概率分布和真实答案算交叉熵损失(真实词的概率越高,损失越小)
- 生成时:从分布里选一个词。最简单是取概率最大的(贪心),也可以按概率随机抽(配合 temperature、top-k、top-p 控制随机程度)
权重共享:这个 Linear 的权重矩阵 [V, d] 和 Embedding 表 [V, d] 形状一样,原论文让两者共用同一份参数,既省参数,又让「词→向量」和「向量→词」互相对应。
八股:
Q1:Decoder 最后的 Linear 和 Softmax 分别做什么?
Linear 把 d 维隐藏向量映射到词表大小 V,得到每个词的 logits;Softmax 把 logits 归一化成概率分布,表示每个词作为下一个词的概率。
Q2:训练时用什么损失函数?
交叉熵损失:对每个位置,取真实下一个词的预测概率,计算 -log(p),所有位置取平均。
Q3:生成时有哪些解码策略?
贪心(取最大概率)、Beam Search(同时保留多个候选序列)、随机采样(配合 temperature、top-k、top-p)。翻译常用 Beam Search,对话大模型常用 top-p 采样。
