DQN进阶
1. 双深度Q网络(double DQN,DDQN)
为了解决DQN中高估(overestimation)的问题,引入了DDQN,标准DQN中
$$
y = r +\gamma \max_{a'}Q_{target}(s',a')
$$
DQN中的Q值为
$$
Q_{target}(s', \arg \max_{a'}Q_{target}(s', a'))
$$
DDQN中的Q值为
$$
Q_{target}(s', \arg \max_{a'}Q_{main}(s', a'))
$$
意思就是main网络选择了动作A,然后让target网络计算A多少分。主要用到的思想就是交叉验证
1.2 竞争深度Q网络(dueling DQN)
1.3 优先级经验回放(prioritized experience replay,PER)
1.4 彩虹(rainbow)
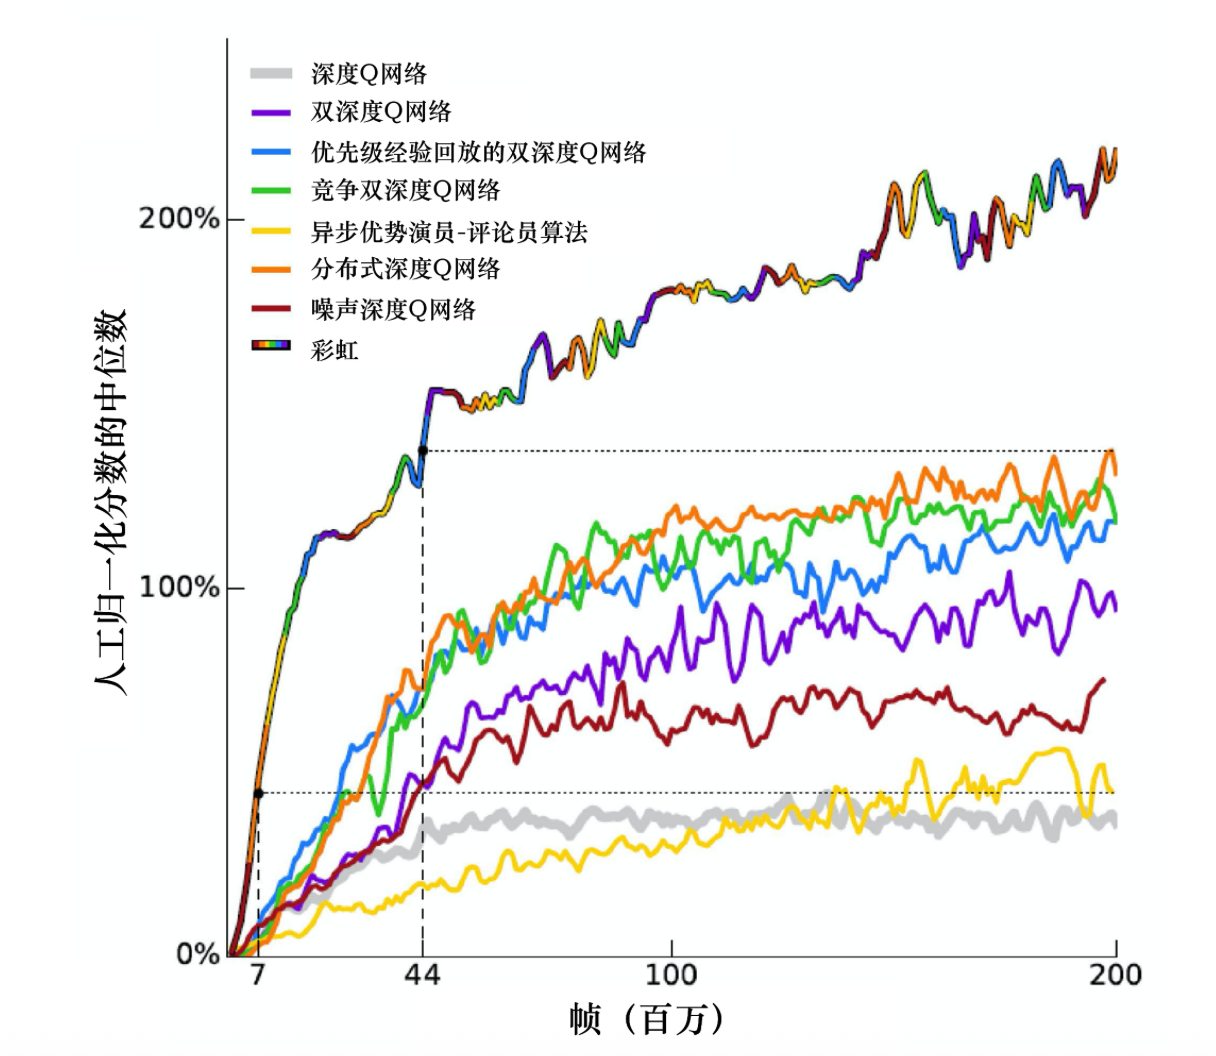
我觉得这是一个好方法,尤其可以用在消融实验里,所有的办法都用的就是彩虹,后续可以去掉一个模块,进行分门对比
