PPO
理解
首先是大模型工业目前常用到的顺序为:
1 | fine-turn |
RL有很多,比如说PPO,GRPO等等
为什么需要RL呢?
PPO有四个部分组成,分别为Actor, critic, Reference, Reward。针对ppo的输入大模型,就是SFT后的大模型。准确的来说,就是SFT后,大模型的query
后续举例为,query两种,即‘中国的首都在哪’,‘1+1=?’; answer两种,即’中国的首都在北京’,‘1+1=2’
1. Reward
这个LLM用来输出分量概率,可以只放query也可以放query+answer。输出应该是一个分数(0-1或0-100,自定义),如’北京‘打分90,‘2’打分100
reward模型可以是第三方,也可以自己训练,重点是参数无需更新
2. Critic
这个LLM属于Actor的私人教练,因为Actor很容易偷懒,当复杂问题回答一直出错会选择逃避,兼顾题目的简单与困难难度。假设score(北京)=20, score(2)=100,此时用Reward-Critic就是70
Critic也需要更新参数,目标是让 $V$ 逼近实际回报, 因为在更新后才能知道题目的难度和Actor的当前知识
Critic和Actor都需要一个参数量(如同为7B),所以PPO显存耗用很大
3. Reference
这个LLM用于约束Actor的输出和reward hacking,考虑一个场景,query为‘中国的首都在哪’时,Actor回答‘中国的首都在呢?可能在南方,也有可能¥#在北方,…….,所以应该在北京’。此时打分正常,但过于冗余。
计算指标为:先计算当前输出的句子概率,再计算Reference的句子概率。
句子概率:每个后token的概率相乘
Reference一般为SFT后LLM的备份,无需更新参数
4. Actor
如何更新Actor_LLM的参数?先看Advantage公式理解表示
A越大,就说明越好,由此引出Loss的公式理解表达
$P_{new}$为当前的Actor模型,$P_{old}$为上一步训练得出的Actor模型
理论
先放出clip公式
首先,针对$\mathbb{E}_{s\sim\nu_\theta}\mathbb{E}_{a\sim\pi_\theta(\cdot\mid s)}$,其实就是我们需要在老的策略中进行采样以进行求期望的数据准备
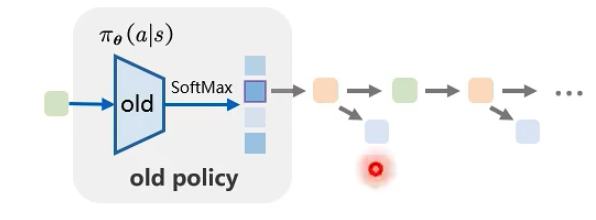
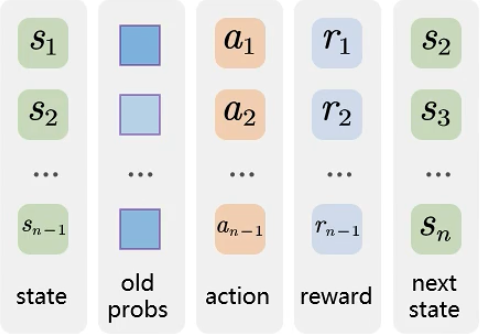
把采样结果存成一张表(buffer)
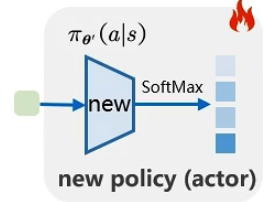
然后针对$\pi_{\theta'}(a\mid s)$,通过Actor求解
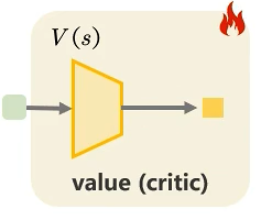
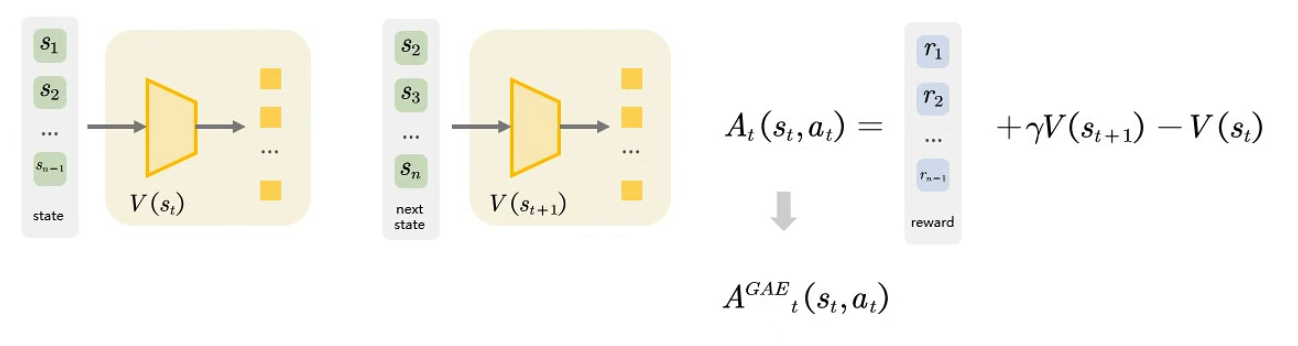
又因为有优势函数A,我们还需要一个Critic来计算他的价值V
接下来就是PPO的经典流程用 Critic 计算 $V(s_t)$和$V(s_{t+1})$。之后计算$A_t(s_t, a_t)$.在通过GAE转化为$A^{GAE}_t(s_t, a_t)$
同理,计算$\pi_{\theta'}(a\mid s)$
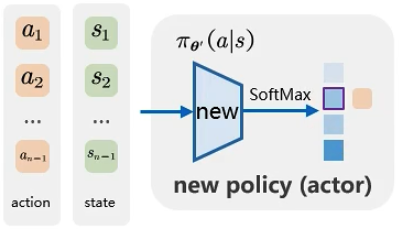
为什么还有一个action?因为我们需要进行比值来计算新旧策略的变化。最后通过PPO反向传播这个Actor,进行更新
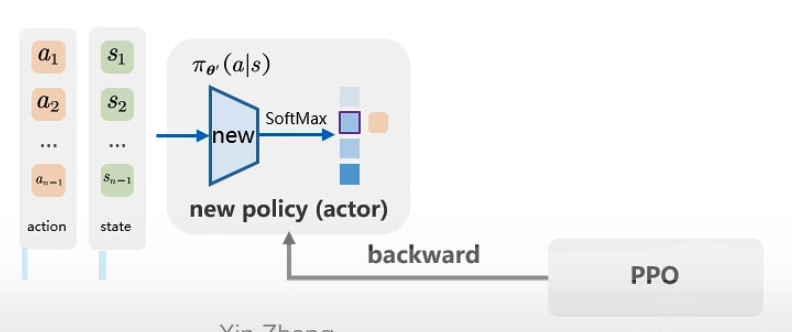
同一批数据会重复训练几个 epoch,所以才需要比值 + clip 防止新策略跑太远;训练完 old ← new,丢掉旧数据,重新采样。
LLM in PPO
依旧先摆出公式
其中,$q \sim P(Q)$为从问题库中抽一个问题,$o \sim \pi_{\theta_{\mathrm{old}}}(O \mid q)$为通过旧策略生成一个回答。总体就是一个语料库,对其进行梯度更新
$\frac{\pi_\theta(o_t \mid q,o_{<t})}{\pi_{\theta_{\mathrm{old}}}(o_t \mid q,o_{<t})}$就是新策略和旧策略的概率值
优势函数$A_t$分为两个部分,分别为奖励和对当前状态的判断(V)
1. min左
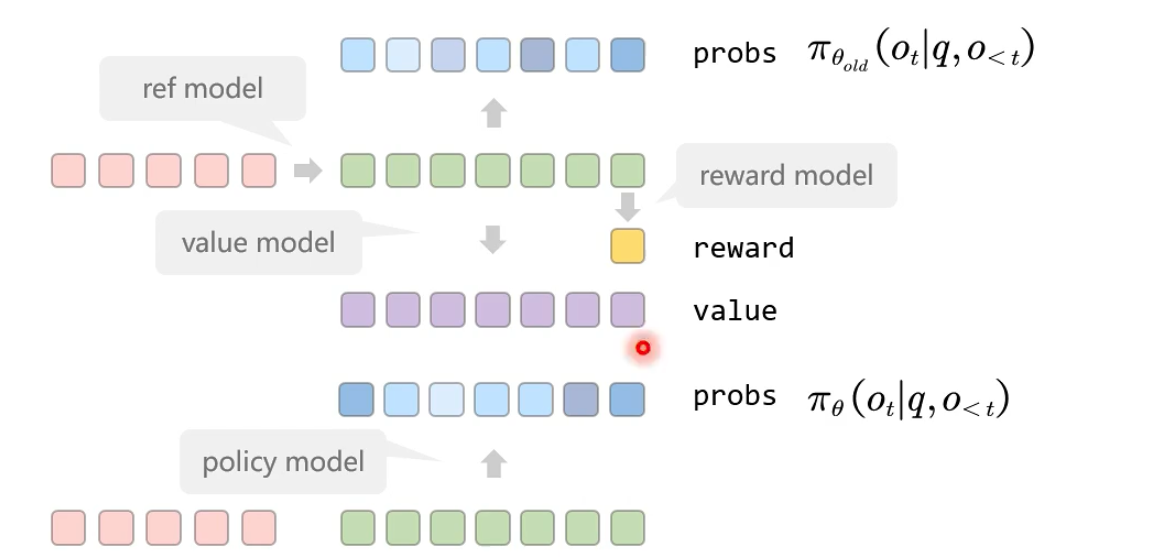
旧 Actor 对 query 生成回答 o,再把 q+o 做一次前向,挑出每个生成 token 的概率,得到 π*θold。更新时新 Actor 对同一条 q+o 再前向一次,得到新策略$\pi_{\theta_{\mathrm{}}}$
$A_t$有两步走,首先经过value model(Critic)得到value,接着在经过reward得到其带来的奖励。
不过在正式计算中,并不是只有reward里得到的这个值,它需要进行一些计算
第一部分就是reward LLM得到的值,第二部分可以理解为一个KL散度,目的是不能让新旧策略相差太远。所以总的流程就是
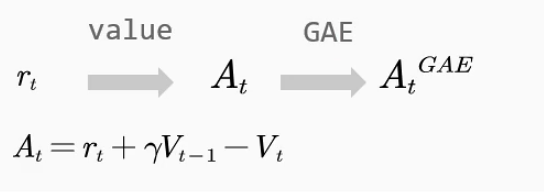
2. clip
Clip 机制是什么?
Clip 机制就是将这个比值强行限制在区间$[1-\epsilon,1+\epsilon]$内(ε 通常为 0.2),防止策略一步更新过大。
为什么 clip 了外面还要计算一次 min?
PPO 的 min 确保了 clip 目标函数是真实目标函数的一个保守估计,即,它一定 ≤ 未 clip 过的原始目标函数。
这样,如果 r 过大 / 过小且 advantage 为负 / 为正,min 之后,仍然会取到有梯度的 原始目标函数,从而达到“修正往反方向跑的过远的策略”的效果。
3. 总
在计算完之后,就可以通过$J(\theta)$来更新policy model(actor),用TD更新
