RL基础篇
1. 四元组
强化学习基础不多说了
2. 马尔可夫链
当前状态只和前一状态相关
1 | s1 -> a1 -> s2 -> a2 -> ... -> an -> sn |
由此可以定义第一个概念return,即
但是有一个问题,该return是无穷大且无法收敛,且未来收益或许没这么重要,所以加一个折扣因子$\gamma$后,即
3. 随机性与期望
给定一个s状态,当前有三个a可选
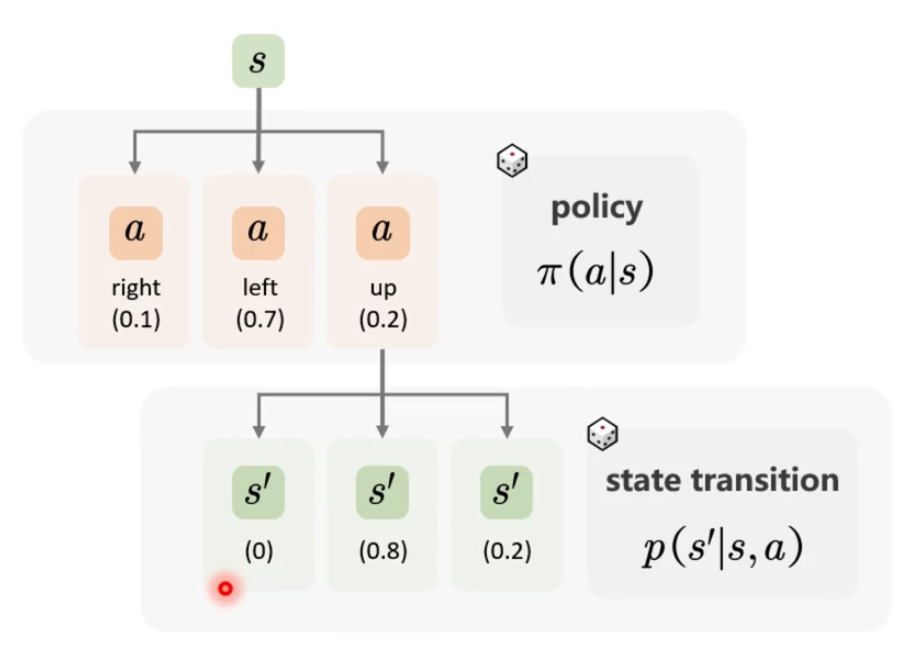
由此给出期望计算公式,即选取动作的概率*得到的奖励
再给出state value,即$V_{\pi}(s)$,目标是对所有动作和所有下一状态求平均的“即时奖励 + 折扣后的下一状态价值
接着是action value, 即$Q_{\pi}(s, a)$
关系为,也就是状态的价值 = 各个动作的价值
4. 分类
1 | -> Monto Carlo |
5. Value-based
目的是优化Q函数
$R_t$ 是随机变量:还没发生,取值不确定,所以可以对它求期望 $\mathbb{E}[R_t]$
5.1 Monto Carlo
做n次轨迹,得到n对(s, a)
但是需要结束一局游戏,时间耗费很久
Mc的本质就是第一步观测奖励R,之后也也全部观测,一直走到结束,特点是方差大,偏差小
5.2 Temporal Difference
考虑一种场景
1 | 总车程: |
一般认为,reality会更加精确,因为首先前10分钟已发生,其次后者时间更少
$r_t$ 是观测值:已经发生了,是一个具体的数
TD本质就是第一步观测奖励R,之后用当前的 Q 估计来补,特点是方差小,偏差大
5.2.1 SARSA
流程如图所示
1 | r |
然后维护一张Q表
| a1 | a2 | a3 | |
|---|---|---|---|
| s1 | 23 | ||
| s2 | |||
| S3 |
在已知s的情况下,以1-e的概率选Q最大的动作,e概率随机选。新Q值计算指标就是TD公式,即
$a'$ 也是用同一个 ε-greedy 选出来的,而且下一步真的会执行它。所以 SARSA 学到的是当前这个 ε-greedy 策略自身的价值 $Q_\pi$,属于 on-policy。
5.2.2 Q-Learning
就是换成了max,选拿 $s'$ 这一行里最大的 Q 值当目标
设 $\alpha = 0.1$,$\gamma = 0.9$,$Q(s_1, a_1) = 23$,拿到 $r = 5$ 后到达 $s_2$。$s_2$ 这一行是:
| a1 | a2 | a3 | |
|---|---|---|---|
| s2 | 10 | 30 | 40 |
假设 ε-greedy 这次碰巧随机探索,选中了 $a_2$:
- SARSA:用实际选的 $a_2$,目标 $= 5 + 0.9 \times 30 = 32$,更新后 $Q(s_1, a_1) = 23.9$
- Q-learning:用最大的 $a_3$,目标 $= 5 + 0.9 \times 40 = 41$,更新后 $Q(s_1, a_1) = 24.8$
本质就是行为策略是 ε-greedy(负责探索),目标策略是 greedy(取 max),两者不同,所以是 off-policy,学到的是最优的 $Q^*$
5.3 DQN
解决的是状态太多、Q 表存不下的问题;动作必须是离散的,通过回归求解,用一个网络 $Q_\theta$ 来近似 Q
输入状态 $s$,一次输出所有动作的 Q 值
6. policy-based
6.1 Policy Gradient
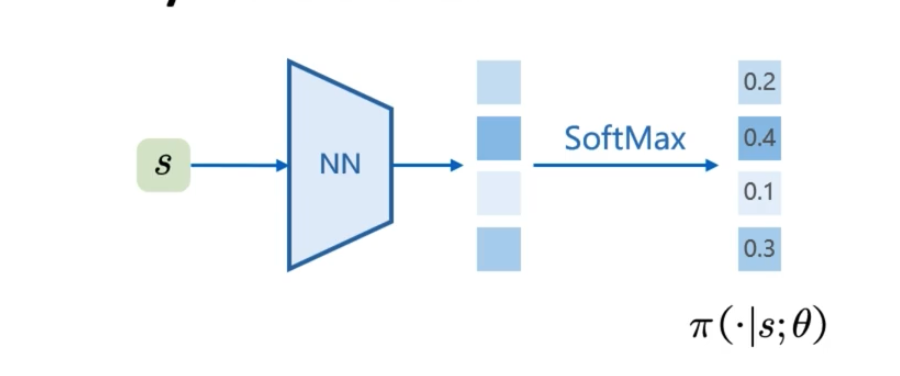
给定一个状态s, 在经过NN后还应该通过softmax得到每个动作a选择到的概率。$\pi(\cdot \mid s;\theta)$ 为在状态 $s$ 下、参数为 $\theta$ 的策略给出的动作分布
**不是只选择最大概率的那个动作,最后一层输出为抽样的概率(训练时用,构建每一个轨迹)**原因:① 探索,让其他动作也有机会被尝试;② 策略梯度是对 $a \sim \pi_\theta$ 求期望,样本必须按 $\pi_\theta$ 抽。部署时可以改用 greedy。
该网络的目的是最大化reward
采用梯度上升(因为是max而不是min优化)更新
其中,
$A_t$ 可以是回报 $U_t$(REINFORCE),也可以是优势 $U_t - V(s_t)$(Actor-Critic)。$A_t > 0$ 就提高这个动作的概率,$A_t < 0$ 就降低,$|A_t|$ 越大调得越多。
$\pi_{\theta}(a_t|s_t)$为在第 $t$ 步、状态 $s_t$ 下,策略网络给实际选中的动作 $a_t$ 的概率
在已知如下式的情况下,$\pi(.)$很好求,将动作a输入到神经网络,很容易得到概率的一个值(把状态 $s$ 输入网络,softmax 得到整列概率 0.2 / 0.4 / 0.1 / 0.3,这一步实际抽到的是第 2 个动作,就按下标取出 0.4,这就是 $\pi(a \mid s;\theta)$),但$Q_{\pi}(s, a)$难求,由此引出如下两种方法
6.1.1 REINFORCE
类似于蒙特卡洛,先计算$u_t$,即这条轨迹从第 $t$ 步开始,实际拿到的折扣回报
这样就可以得到
6.1.2 Actor-Critic
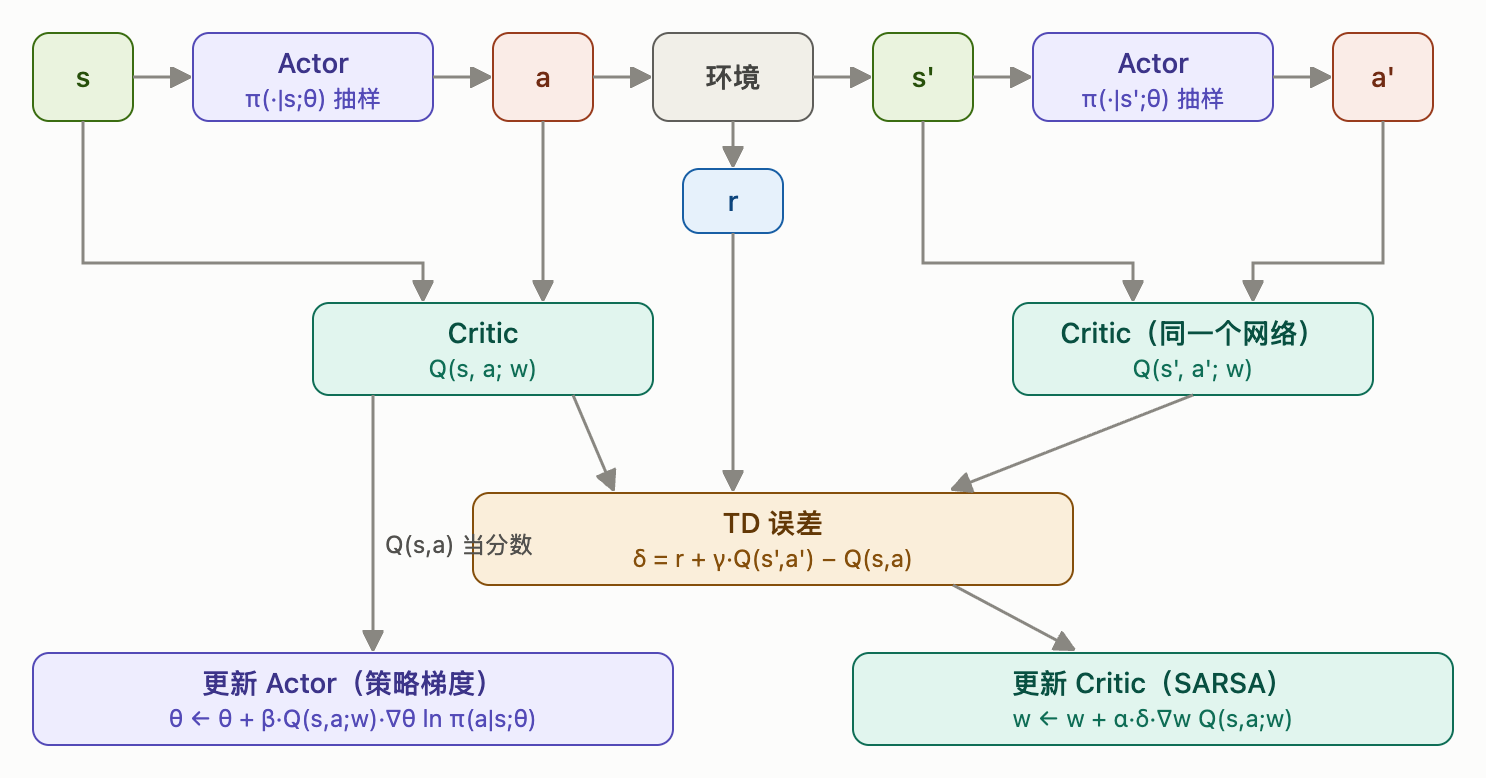
给定状态 $s$,Actor 抽样出动作 $a$,执行后得到奖励 $r$ 和下一状态 $s'$,Actor 再抽样出 $a'$。把 $(s,a)$ 和 $(s’,a’)$ 分别输入 Critic 得到 $Q(s,a)$ 和 $Q(s’,a’)$,用 TD 误差 $\delta = r + \gamma Q(s',a') - Q(s,a)$ 更新 Critic,再用 $Q(s,a)$ 通过策略梯度更新 Actor。
例:
设定
- 一条走廊,在状态 $s_1$ 可以往左或往右走
- 参数:$\gamma = 0.9$,Critic 学习率 $\alpha = 0.1$,Actor 学习率 $\beta = 0.1$
- 为了好算,假设 Actor 的参数就是两个动作的 logits,一开始都是 0,所以 $\pi(\text{左} \mid s_1) = \pi(\text{右} \mid s_1) = 0.5$
- Critic 当前的估计:$Q(s_1, \text{右}) = 2.0$,$Q(s_2, \text{右}) = 3.0$
第 1 步:Actor 抽样选动作
按 0.5 / 0.5 抽样,抽到了“右”,所以 $a = \text{右}$。
第 2 步:执行,环境给反馈
往右走拿到奖励 $r = +1$,到达 $s_2$。
第 3 步:Actor 在 $s_2$ 再抽样
抽到 $a' = \text{右}$。只用来算 Q,下一轮才真的执行。
第 4 步:Critic 打分
- 输入 $(s_1, \text{右})$,得到 $Q(s,a) = 2.0$
- 输入 $(s_2, \text{右})$,得到 $Q(s',a') = 3.0$
第 5 步:算 TD 误差,更新 Critic
$\delta > 0$,说明 Critic 低估了“在 $s_1$ 往右走”。它的参数被调整,让 $Q(s_1, \text{右})$ 往目标 3.7 靠。按表格的方式理解,大约是 $2.0 + 0.1 \times 1.7 = 2.17$。
第 6 步:用 Q 更新 Actor
对 softmax 来说,$\ln \pi(\text{右})$ 对两个 logit 的梯度分别是:
- 对“右”的 logit:$1 - \pi(\text{右}) = 0.5$
- 对“左”的 logit:$-\pi(\text{左}) = -0.5$
代入 $\beta = 0.1$,$Q = 2.0$:
- “右”的 logit:$0 + 0.1 \times 2.0 \times 0.5 = +0.1$
- “左”的 logit:$0 + 0.1 \times 2.0 \times (-0.5) = -0.1$
softmax 之后:
往右的概率从 0.5 涨到了 0.55。
第 7 步:进入下一轮
$s \leftarrow s_2$,$a \leftarrow \text{右}$,重复上面的过程。
6.1.3 baseline
实际上就是减去了一个均值,这样使得reward有负有正,减少方差
6.2 TRPO
在TRPO之前引入信赖域,只在近似可信的一小块区域里做优化。因此我们需要在一个小区域之间,逐步提升。所以Trust Region可表示为
TRPO 不用参数距离,而是用新旧策略的 KL 散度来衡量“走了多远
所以TRPO更新公式为
TRPO 用旧策略采的数据,通过重要性采样估计新策略的优势,并用 KL 约束保证新旧策略足够接近,从而让每次更新都稳定提升。
6.3 PPO
6.3.1 PPO-Penalty
TRPO 的 KL 是硬约束,难以求解,这个方法就是通过减法将把约束改成惩罚项,即
6.3.2 PPO-Clip
把概率比截断
- 如果 $\hat{A} > 0$,想让目标变大,优化器会把 $r$ 一直往上推,没有上限
- 如果 $\hat{A} < 0$,会把 $r$ 一直往 0 压
clip 的做法是:把 $r$ 限制在 $[1-\epsilon,\ 1+\epsilon]$ 之内,超出部分不再给奖励
| 情况 | $r$ | min 选了谁 | 结果 |
|---|---|---|---|
| $\hat{A} > 0$,好动作 | 1.5(已经涨很多) | clip 后的 1.2 | 截断,梯度为 0,不再继续涨 |
| $\hat{A} > 0$,好动作 | 0.6(反而降了) | 原始的 0.6 | 不截断,继续把概率拉回来 |
| $\hat{A} < 0$,坏动作 | 0.5(已经降很多) | clip 后的 0.8 | 截断,不再继续压 |
| $\hat{A} < 0$,坏动作 | 1.5(反而涨了) | 原始的 1.5 | 不截断,继续把概率压下去 |
6.4 Generalized Advantage Estimation(GAE)
MC和TD都有劣势,融合办法就是多步TD,GAE就是
GAE 是所有 k 步优势的指数加权平均。$\lambda$ 控制看多远:
- $\lambda = 0$:只剩 $A^{(1)}$,即一步 TD
- $\lambda = 1$:退化成蒙特卡洛
通过调 $\lambda$,就能在偏差和方差之间折中。
