常用, 但是稍复杂的功能函数
1. tf.gather
该函数可以根据索引号收集数据 假设共有4个班级,每个班级35个学生,8门科目,保存成绩册的张量shape为[4,35,8].
1 | x = tf.random.uniform([4, 35, 8], maxval=100) |
收集第 1~2 个班级的成绩册,可以给定需要收集班级的索引号:[0,1],并指定班级的维度 axis=0,通过 tf.gather 函数收集数据
1 | tf.gather(x, [0, 1], axis=0) |
抽查所有班级的第 1、4、9、12、13、27 号同学的成绩数据
1 | tf.gather(x,[0,3,8,11,12,26],axis=1) |
要收集所有同学的第3和第5门科目的成绩:
1 | tf.gather(x,[2,4],axis=2) # 第3,5科目的成绩 |
2. tf.gather_nd
该函数可以实现采样多个点(多维) 抽查第2个班级的第2个同学的所有科目,第3个班级的第3个同学的所有科目,第4个班级的第4个同学的所有科目
1 | tf.gather_nd(x,[[1,1],[2,2],[3,3]]) |
3. tf.boolean_mask(感觉可能没啥用?)
以掩码方式进行数据提取,采样第 1 和第 4 个班级的数据
1 | tf.boolean_mask(x, mask=[True, False, True, False], axis=0) |
4. tf.where(说白了就是筛选,和sql一个东西)
通过tf.where(cond, a, b)操作可以根据cond条件的真假从参数?或?中读取数据,条件判定规则如下
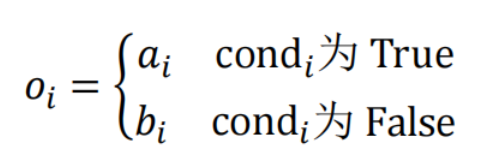
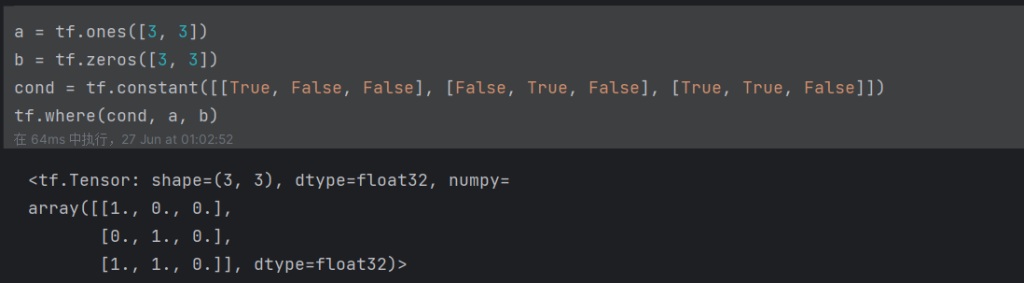
当参数a=b=None时,即a和b参数不指定,tf.where会返回cond张量中所有True的元素的索引坐标
5. scatter_nd
该函数可以高效地刷新张量的部分数据,但是这个函数只能在全0的白板张量上面执行刷新操作
原理:
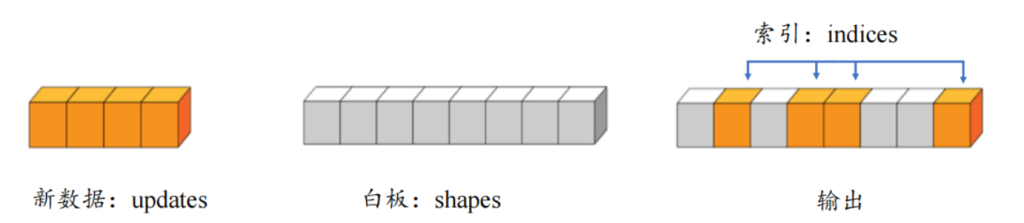
参数为:tf.scatter_nd(indices, updates, shape)
需要刷新的数据索引号通过indices表示,新数据为updates。根据indices给出的索引位置将updates中新的数据依次写入白板中,并返回更新后的结果张量 实例:
indices = tf.constant([[4], [3], [1], [7]]) # 构造需要刷新数据的位置参数,即为4、3、1和7号位置
print(indices)
updates = tf.constant([4.4, 3.3, 1.1, 7.7]) # 构造需要写入的数据,4号位写入 4.4, 3号位写入3.3…以此类推
print(updates)
tf.scatter_nd(indices, updates, [8]) # 在长度为8的全0向量上根据indices写入updates数据
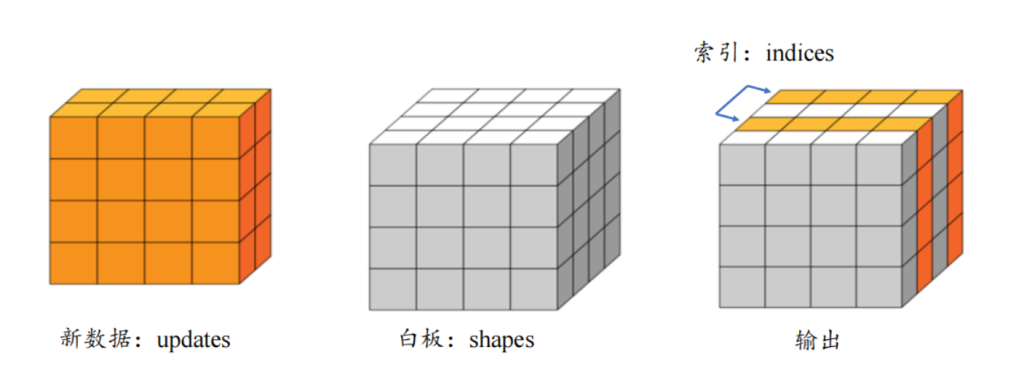
3D张量跟新示意图
实例:
1 | indices = tf.constant([[1], [3]]) |
6. meshgrid(画图的,你懂的必须学)
生成二维网格的采样点坐标,方便可视化等应用场合。考虑2个自变量x和y的Sinc函数表达式为
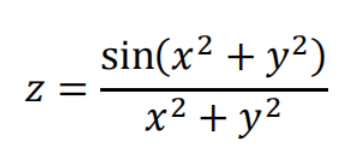
1 | x = tf.linspace(-8., 8, 100) # 设置 x 轴的采样点 |
批训练(高贵的gpu)
1 | train_db = train_db.batch(128) # 设置批训练,batch size 为 128 |
预处理(高贵的自动化)
1 | train_db = train_db.map(preprocess) |
