拼接
合并是指将多个张量在某个维度上合并为一个张量。以某学校班级成绩册数据为例,设张量?保存了某学校 1~4 号班级的成绩册,每个班级 35 个学生,共 8 门科目成绩,则张量?的 shape 为:[4,35,8];同样的方式,张量?保存了其它 6 个班级的成绩册,shape [6,35,8]。通过合并这 2 份成绩册,便可得到学校所有班级的成绩册,记为张量?,shape 应为[10,35,8],其中,10 代表 10 个班级,35 代表 35 个学生,8 代表 8 门科目 合并代码如下:
1 | a = tf.random.normal([4, 35, 8]) |
堆叠
?保存了某个班级的成绩册,shape 为[35,8],张量?保存了另一个班级的成绩册,shape 为[35,8]。合并这 2 个班级的数据时,则需要创建一个新维度,定义为班级维度,新维度可以选择放置在任意位置,一般根据大小维度的经验法则,将较大概念的班级维度放置在学生维度之前,则合并后的张量的新 shape 应为
1 | [2,35,8]a = tf.random.normal([35, 8]) |
不能创建维度,只能在已有的维度上进行堆叠
分割
得到整个学校的成绩册张量,shape 为[10,35,8],现在需要将数据在班级维度切割为10个张量,每个张量保存了对应班级的成绩册数据
1 | x = tf.random.normal([10, 35, 8]) |
数据统计
向量范数
向量范数(Vector Norm)是表征向量“长度”的一种度量方法,它可以推广到张量上。在神经网络中,常用来表示张量的权值大小,梯度大小等
- L1范数,定义为向量?的所有元素绝对值之和
tf.norm(x, ord=1)
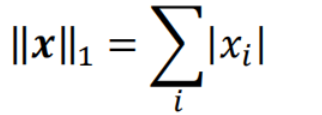
L2 范数,定义为向量?的所有元素的平方和,再开根号tf.norm(x, ord=2)
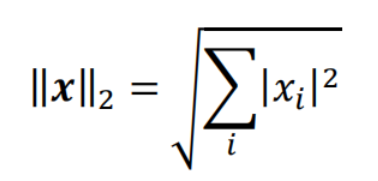
∞ −范数,定义为向量?的所有元素绝对值的最大值tf.norm(x, ord=np.inf)
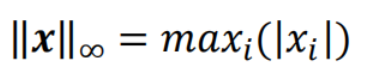
最值,均值,和
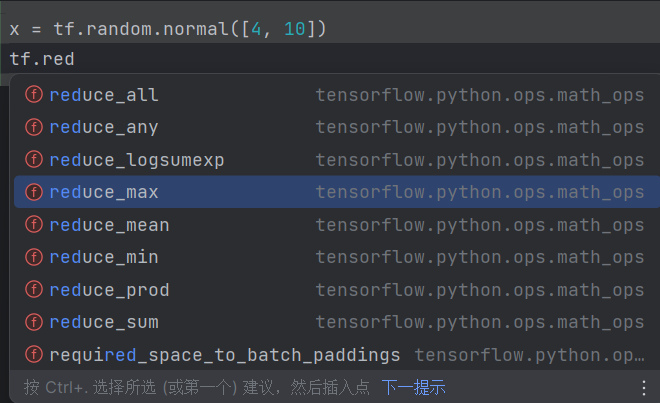
敲个reduce_,什么都出来了。具体看自己想要什么
例子:
1 | x = tf.random.normal([4, 10]) |
张量比较
将预测结果和真实标签比较,统计比较结果中正确的数量来计算准确率 常用函数比较:
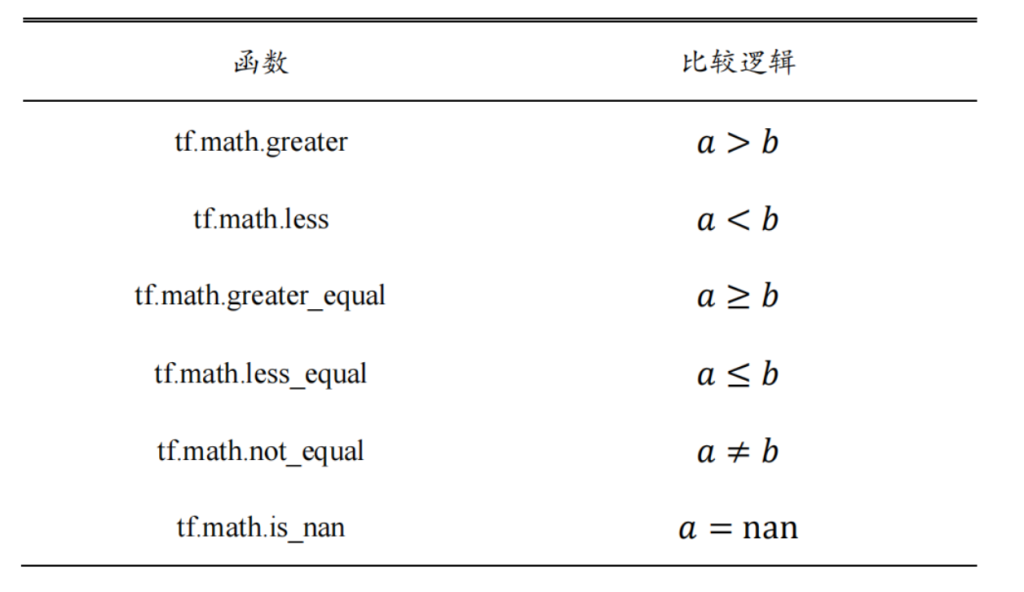
数据限幅
通过函数实现数据的下限幅与上限幅
1 | x = tf.range(9) |
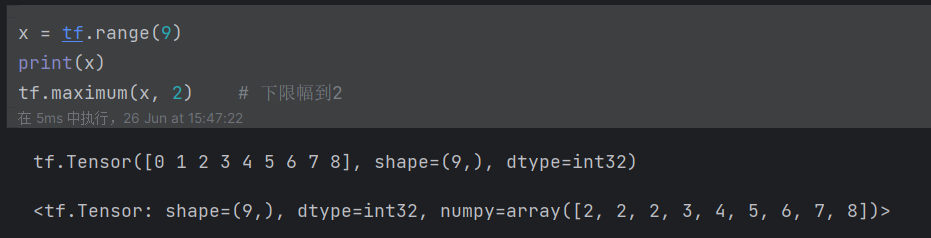
使用函数tf.clip_by_value实现上下限幅
1 | x = tf.range(9) |
